AI-агенту не обязательно взламывать саму модель или находить критическую уязвимость в инфраструктуре компании. Иногда достаточно связки из нескольких обычных корпоративных сервисов, настроенных с избыточными правами. Это показал санкционированный тест безопасности, в ходе которого исследователи Cathedral заявили о доступе к части внутренних систем Anthropic менее чем за 12 часов.
История важна не только для Anthropic. Она показывает, как меняется корпоративный риск с появлением автономных агентов: слабым местом становится уже не отдельное приложение, а маршрут между CRM, HR-системой, IT-инструментами и мессенджером.
Что произошло во время теста
Cathedral — стартап, который занимается автоматизированным поиском уязвимостей. В рамках программы для внешних исследователей его команда проверяла защищённость Anthropic. Сначала специалисты работали вручную, а затем подключили AI-агентов.
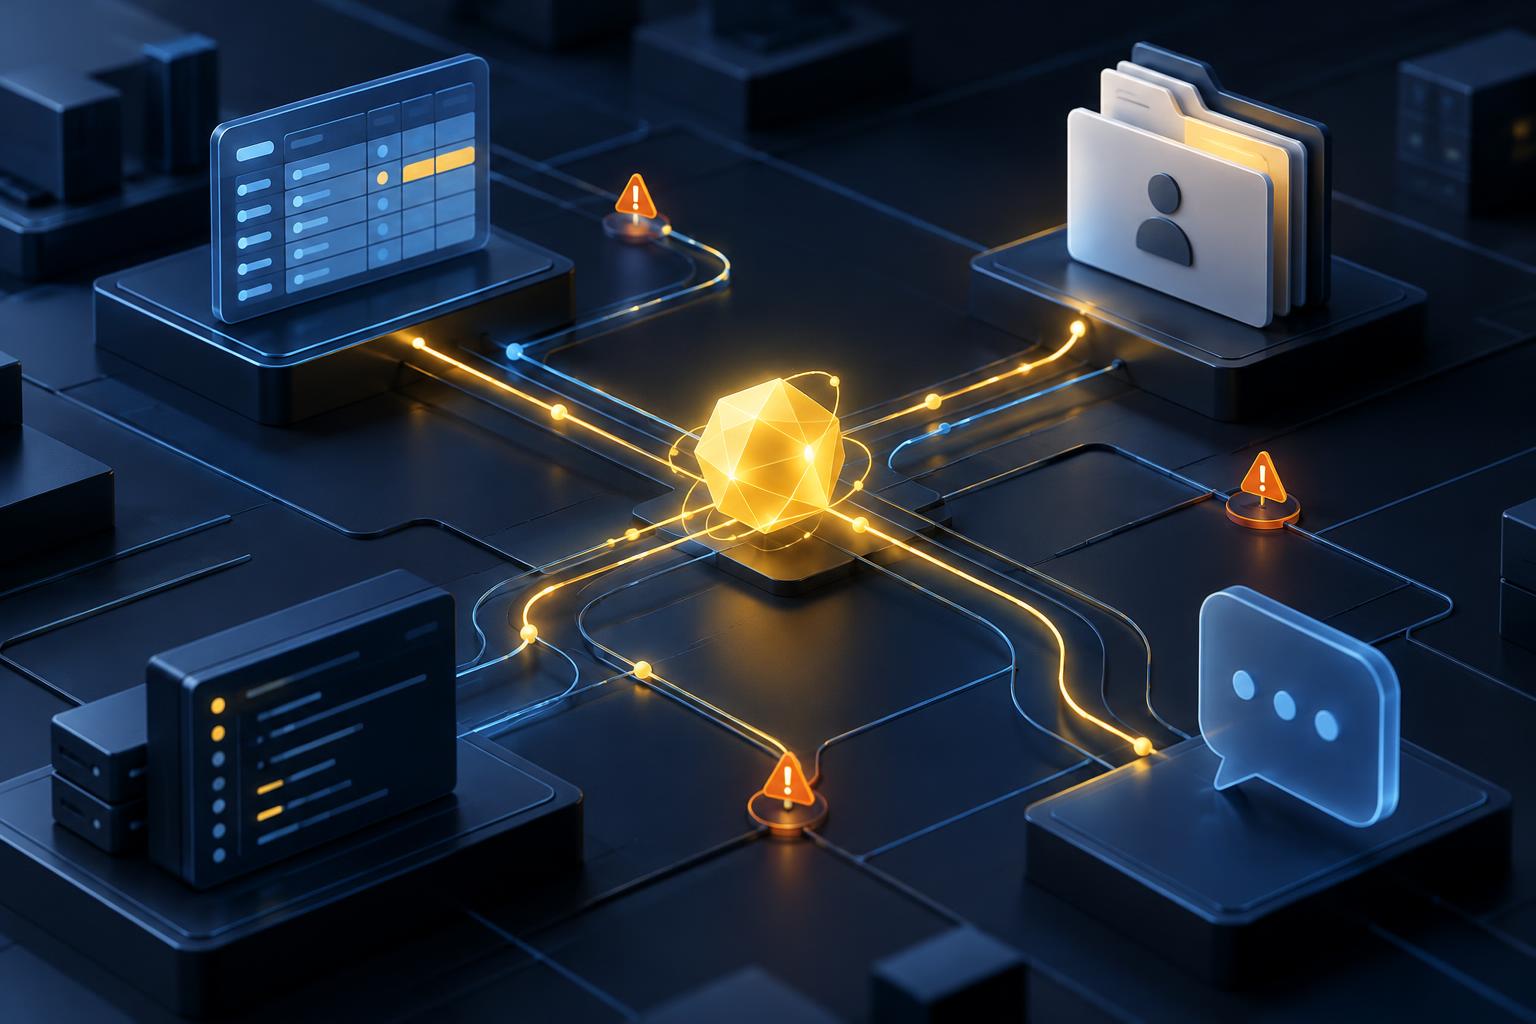
По версии Cathedral, агенты менее чем за 12 часов нашли путь во внутренние бизнес-системы Anthropic через стороннее корпоративное программное обеспечение. Речь шла о связке интеграций и неправильно настроенных разрешений, а не о взломе самой модели Claude.
Исследователи утверждали, что получили доступ к отдельным данным из систем продаж, HR и IT, а также к внутренним сообщениям и сведениям о сотрудниках. В публичном описании теста упоминались записи встреч, детали зарплат и офферов и обсуждения, связанные с разработкой моделей.
Anthropic подтвердила сам факт тестирования и доступа, но описала масштаб осторожнее. Компания заявила, что речь шла об ограниченном наборе данных, включая контактную информацию и базовые сведения об учётных записях некоторых клиентов и партнёров. Anthropic также оспорила отдельные выводы Cathedral о масштабе и значимости инцидента.
Поэтому корректнее говорить не о полноценном преступном взломе и не о доказанной краже больших массивов данных, а о санкционированной проверке, выявившей неожиданный маршрут к части внутренних систем. Детали и оценка последствий у участников расходятся.
Почему агент оказался эффективнее обычной автоматизации
Классическая автоматизация выполняет заранее заданный сценарий: получает данные из одного сервиса, обрабатывает их и передаёт результат в другой. AI-агент может менять план по ходу работы. Он изучает интерфейс, анализирует найденные документы, ищет новые связи и пробует другой путь, если первоначальный сценарий не сработал.
Для тестирования безопасности это означает резкое увеличение скорости и охвата. Агент способен одновременно:
- читать документацию и описания API;
- сопоставлять данные из разных систем;
- находить доступные токены и разрешения;
- проверять, какие действия разрешены конкретной учётной записи;
- продолжать поиск после блокировки одного из шагов.
При этом агенту не нужна одна «магическая» уязвимость. Цепочка может состоять из нескольких незначительных на первый взгляд проблем:
- подрядчик получил слишком широкие права;
- внутренний сервис доверяет внешней интеграции;
- один токен действует сразу в нескольких системах;
- чувствительные сведения доступны через удобный API;
- система мониторинга фиксирует запросы по отдельности, но не видит их общий смысл.
Каждая такая слабость может казаться приемлемой в изоляции. Вместе они образуют маршрут, по которому агент перемещается между сервисами.
Главная проблема — цепочка доверия
Компании обычно защищают приложения по отдельности. CRM проверяют на одном уровне, HR-систему — на другом, а мессенджер считают внутренним каналом коммуникации. Но агент работает не с отдельными коробками, а с их связями.
Представим типичный сценарий. Агент получает письмо из CRM, извлекает имя клиента, находит соответствующую запись в системе поддержки, сопоставляет её с внутренней карточкой сотрудника, а затем отправляет результат в Slack. Все действия могут быть разрешёнными. Опасным становится их сочетание и отсутствие ограничений на переход между системами.
Такой подход создаёт несколько рисков:
- агент видит связи, которые неочевидны отдельным владельцам сервисов;
- легитимные токены используются вместо вредоносного кода;
- поиск данных проходит под видом обычных рабочих запросов;
- чувствительная информация автоматически перемещается в менее защищённый канал;
- компрометация подрядчика открывает доступ к нескольким внутренним системам.
Именно поэтому безопасность AI-агента нельзя оценивать только по качеству модели. Даже хорошо ограниченная модель становится частью опасной архитектуры, если ей выдали широкий доступ к связанным приложениям.
Что проверить бизнесу до запуска агентов
1. Нарисовать карту доступа
Нужно перечислить все системы, к которым обращаются агенты: CRM, HR, финансы, поддержка, хранилища, IT-сервисы и корпоративные мессенджеры. Важно видеть не только отдельные разрешения, но и возможные маршруты между ними.
2. Разделить права по действиям
Доступ «ко всему сервису» для агента слишком широк. Права на чтение, изменение, экспорт и отправку данных должны выдаваться отдельно. Агент, который формирует отчёт, не должен автоматически получать возможность менять записи или пересылать их наружу.
3. Ограничить переходы между доменами
HR-данные, финансовая информация, CRM и внутренние обсуждения не должны свободно соединяться в одном сценарии. Для каждого перехода стоит определить, какие поля разрешено передавать и требуется ли подтверждение человека.
4. Использовать короткоживущие токены
Постоянные общие ключи создают слишком длинное окно для злоупотреблений. Лучше применять временные токены, отдельные учётные записи агентов и повторную аутентификацию для чувствительных операций.
5. Логировать последовательности
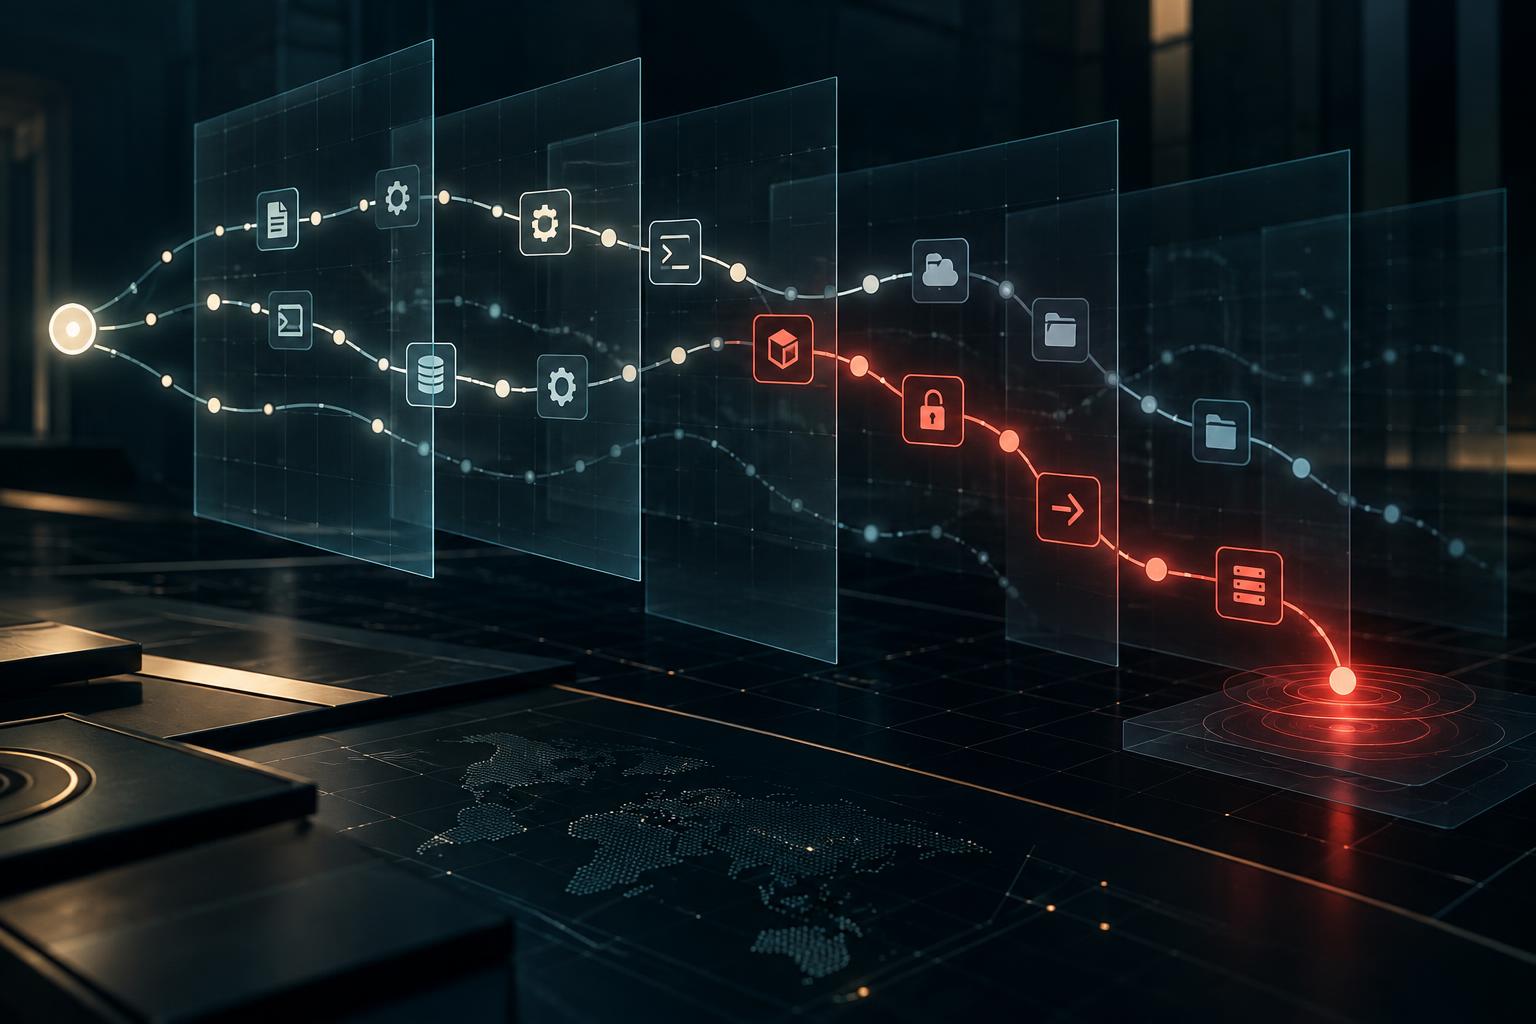
Мониторинг отдельных запросов недостаточен. Система должна показывать, какие данные агент получил, куда перешёл после этого, что сопоставил и какой результат отправил. Аномалией может быть не один запрос, а необычная цепочка из десятков разрешённых действий.
6. Тестировать интеграции, а не только модели
Проверять нужно сценарии, в которых агент действует через подрядчика, API и корпоративные плагины. Отдельный вопрос: что сможет увидеть агент, если одна внешняя учётная запись будет скомпрометирована.
Вывод
Тест Cathedral не доказывает, что AI-агенты способны беспрепятственно взламывать любую компанию. Он показывает другое: автономный агент быстро обнаруживает слабые места в архитектуре доверия, особенно когда корпоративные сервисы соединены широкими правами и общими токенами.
Для бизнеса главный вопрос теперь звучит не так: «Насколько безопасна используемая модель?» Важнее спросить: «Каким маршрутом агент получает результат и что ещё он может увидеть по дороге?» Именно этот маршрут — от HR-софта и CRM до Slack — становится новой границей корпоративной безопасности.


