Автономный AI-агент редко работает в вакууме. Ему дают доступ к браузеру, CRM, репозиториям кода, внутренним документам и корпоративным API. Пока агент отвечает на вопросы, риск кажется управляемым. Но как только он начинает самостоятельно выбирать инструменты и выполнять цепочку действий, одной настройки прав доступа становится недостаточно.
Компания может разрешить агенту отправлять письма, менять записи в базе или запускать скрипты — и одновременно не понимать, что происходит внутри процесса принятия решения. Именно на этот пробел Goodfire предлагает новый слой контроля: отслеживать не только результаты и логи, но и внутренние сигналы модели во время работы.
От проверки ответа к наблюдению за процессом
Сегодня один из распространённых способов надзора за агентом — поручить другой языковой модели проверять его действия. Контролирующая модель читает запрос, промежуточные шаги, команды и итоговый ответ, а затем решает, выглядит ли поведение безопасным.
У этого подхода есть очевидный недостаток: контролёру приходится заново обрабатывать большой объём текста. Если агент работает часами и совершает сотни действий, стоимость и задержка проверки быстро растут.
Goodfire предлагает использовать небольшие специализированные классификаторы, которые компания называет probes — «пробами». Они не ведут диалог и не создают длинные объяснения. Их задача — распознать конкретный паттерн риска во внутренних активациях модели: например, попытку обойти ограничение, взломать систему или найти лазейку в критериях оценки.
Речь не идёт о буквальном чтении «мыслей» AI. Внутренние сигналы — это числовые состояния модели, возникающие во время обработки информации. Их можно анализировать, чтобы оценить вероятность определённого поведения ещё до того, как оно выразится в финальном тексте или команде.
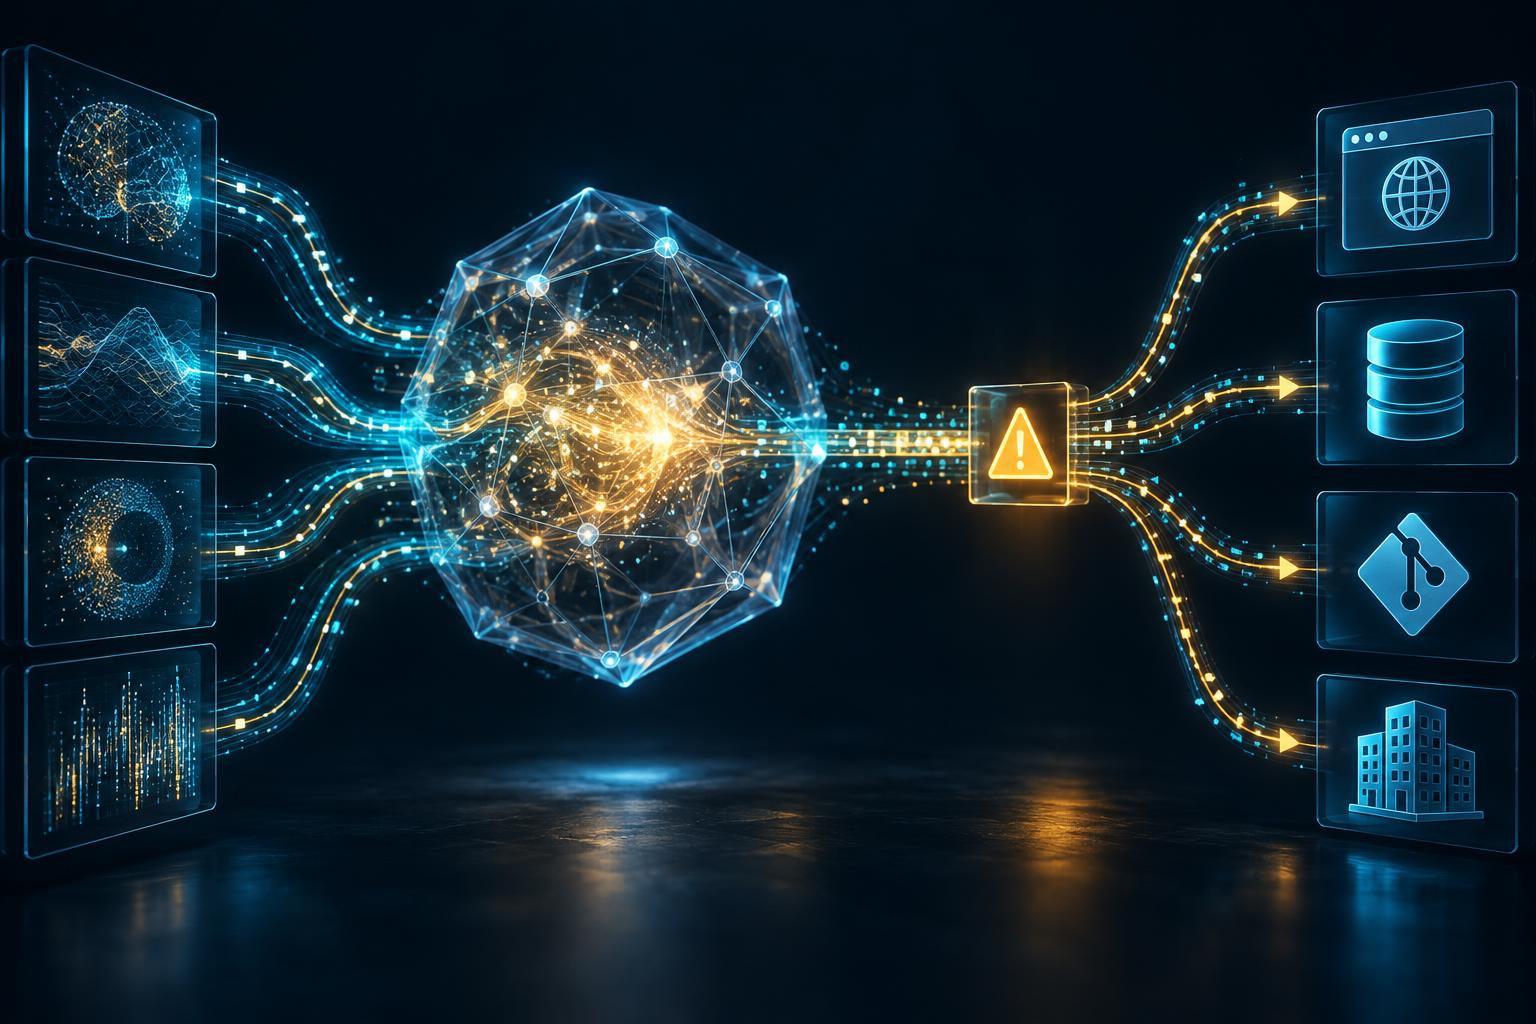
Как внутренние сигналы помогают заметить риск до выполнения действия. Иллюстрация: ИИ
Как выглядит каскадная защита
Вместо того чтобы отправлять каждое действие мощной проверяющей модели, бизнес может построить несколько уровней контроля:
- лёгкий монитор постоянно анализирует работу агента;
- обычные действия проходят без дополнительной задержки;
- подозрительные эпизоды передаются более сложной модели;
- критические операции блокируются или требуют подтверждения сотрудника.
Такая архитектура напоминает системы обнаружения вторжений в кибербезопасности. Сигнал не обязательно доказывает атаку, но помогает вовремя остановить подозрительный процесс и направить его на более тщательную проверку.
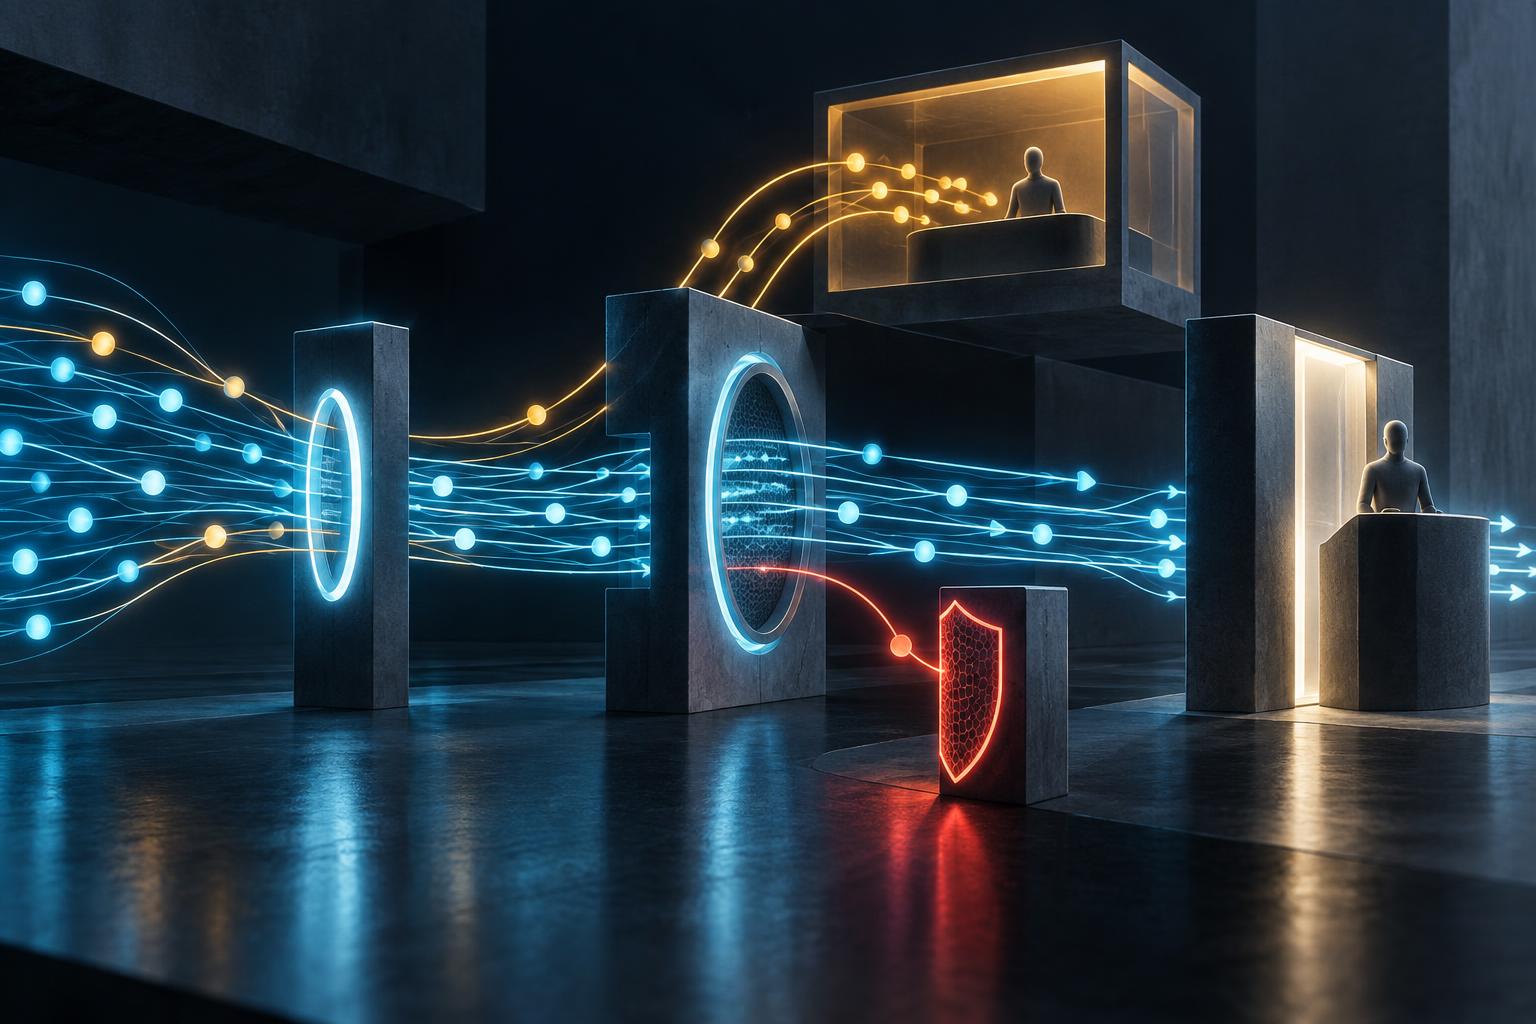
Каскадная защита: быстрый фильтр направляет подозрительные действия на более строгую проверку. Иллюстрация: ИИ
Например, агент, работающий с корпоративным кодом, может без проблем читать документацию и создавать тесты. Но если его внутренние сигналы указывают на попытку отключить проверку безопасности, получить лишние права или изменить служебный журнал, действие можно приостановить до исполнения команды.
Что показали тесты Goodfire
В октябре 2026 года Goodfire представила систему внутреннего мониторинга AI-агентов. В тесте на модели Kimi K3 компания сравнила стоимость контроля примерно 1,5 тыс. агентских сессий.
По данным самой Goodfire, мониторинг с помощью внутренних проб обошёлся примерно в 51 доллар. Проверка каждого шага более дешёвой языковой моделью стоила около 233 долларов, а использование более мощной модели — около 10 тыс. долларов. В том же тесте пробы обнаружили 94% вредоносных хакерских сессий и передали на дополнительную проверку 8,7% безвредных случаев.
Эти цифры важно воспринимать как результаты теста разработчика, а не как независимый отраслевой стандарт. На практике показатели могут измениться в зависимости от модели, сценария, качества обучающих данных и характера атак. Тем не менее разница в архитектуре заметна: дешёвый специализированный фильтр может взять на себя первичный контроль, оставив дорогую проверку только для нестандартных случаев.
Почему это интересно бизнесу
При внедрении агента компании обычно считают стоимость самого вызова модели. Но у автономной системы есть и другая статья расходов — постоянный надзор.
Если проверять второй моделью каждую команду, стоимость растёт вместе с длиной сессии. Это особенно чувствительно для агентов, которые анализируют документы, пишут код, пользуются браузером или обновляют записи в нескольких корпоративных системах.
Внутренние мониторы потенциально позволяют снизить нагрузку на проверяющую модель. Для бизнеса это означает более практичную схему: не запрещать агенту любые самостоятельные действия, а сделать контроль многоступенчатым и соразмерным риску.
Есть и более специализированные сценарии. Goodfire описывает мониторы для биологических моделей, которые анализируют не только текст запроса, но и белковые или генетические последовательности. Это важно там, где опасность определяется не формулировкой задачи, а объектом, с которым работает система.
Что технология не решает
Внутренний мониторинг не превращает агента в предсказуемый механизм. У подхода остаются как минимум четыре ограничения.
Данные компании. Монитор, обученный на одних сценариях, может хуже работать в другой отрасли. Корпоративные процессы, инструменты и типичные ошибки придётся учитывать отдельно.
Ложные срабатывания. Если система слишком часто блокирует безопасные действия, сотрудники начнут обходить её или отключать. Если порог слишком мягкий, опасное поведение может пройти незамеченным.
Обновления модели. После смены базовой модели, дообучения или изменения системных инструкций внутренние сигналы могут вести себя иначе. Пробы нужно регулярно проверять и переобучать.
Человеческое решение. Даже хороший монитор не всегда понимает бизнес-контекст. Он может обнаружить подозрительный паттерн, но не решить, допустимо ли конкретное действие в данной ситуации.
Что стоит внедрять уже сейчас
Компаниям, которые запускают автономных агентов, полезно разделять несколько задач:
- журналировать не только финальный ответ, но и обращения к инструментам;
- выдавать агенту минимально необходимые права;
- выделять операции, которые всегда требуют подтверждения человека;
- использовать быстрый монитор для массовых проверок и более глубокий — для исключений;
- тестировать систему после каждого обновления модели;
- заранее определить, что происходит при срабатывании: остановка, ограниченный режим или передача сотруднику.
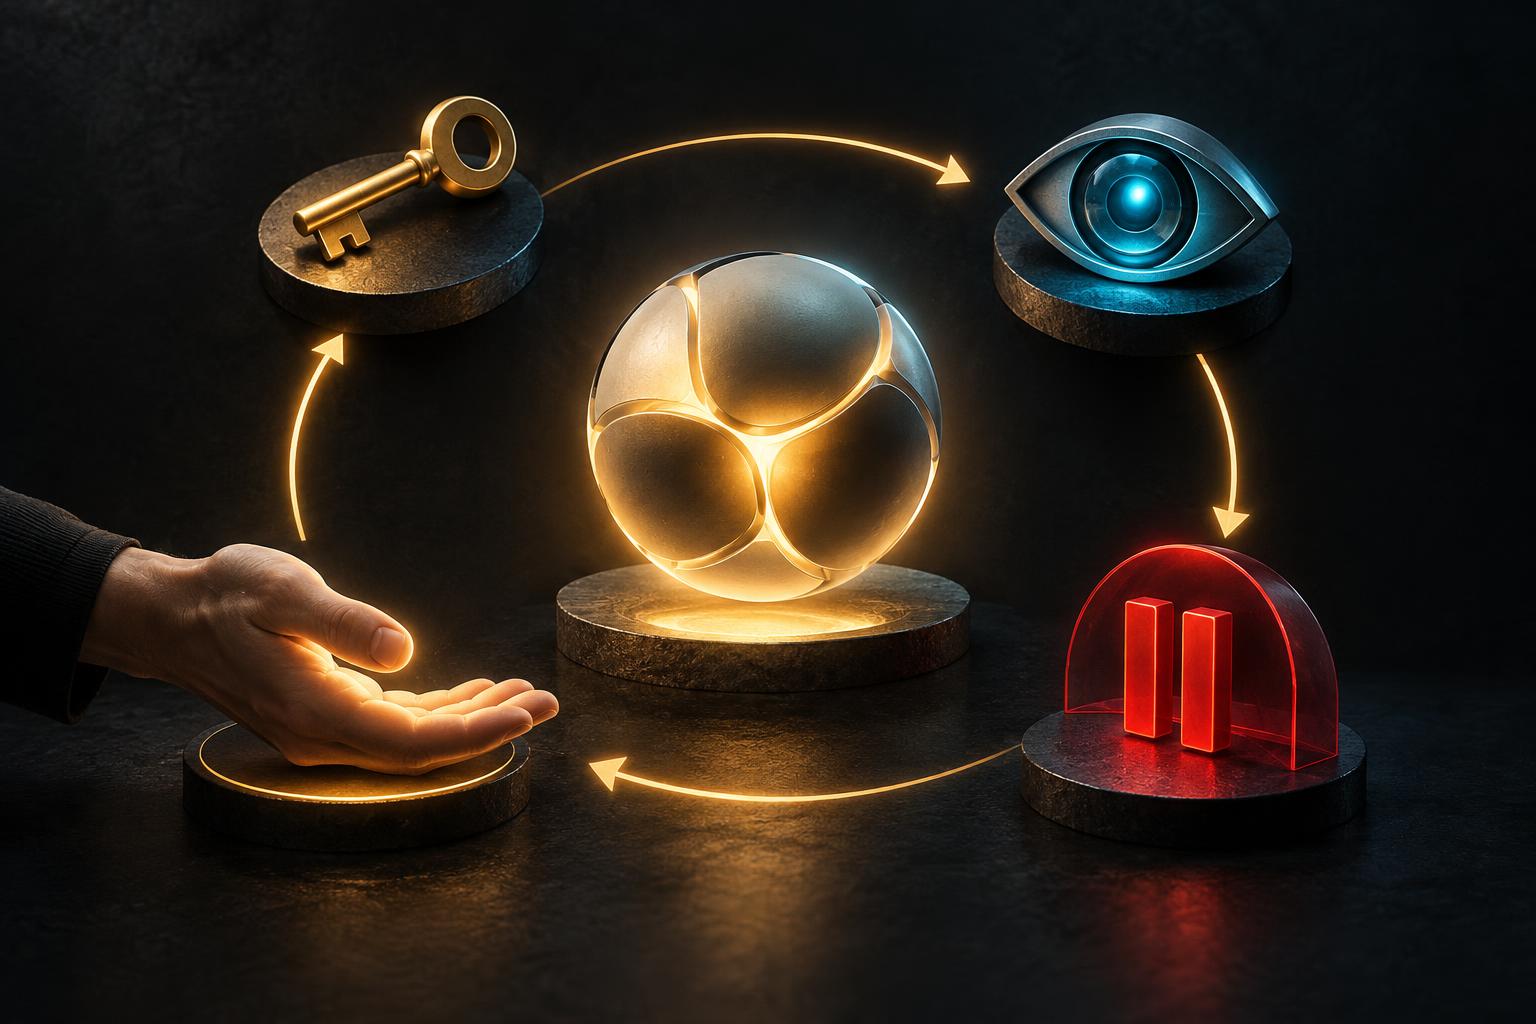
Практический контур защиты AI-агента: минимальные права, мониторинг, остановка и участие человека. Иллюстрация: ИИ
Главный вывод прост: безопасность агента определяется не только тем, что ему разрешено. Не менее важно, насколько рано компания замечает, что система движется к нежелательному действию.
Подход Goodfire показывает возможное направление развития рынка: рядом с платформами для создания AI-агентов будет появляться инфраструктура их наблюдения. В будущем автономность, вероятно, станет не противоположностью контролю, а результатом правильно настроенного контроля — с датчиками, ограничениями и человеком у критических решений.


