Модель перестаёт быть фоном и становится закупаемым ресурсом
16 октября 2026 года сооснователь и CEO Replit Амджад Масад заявил на конференции TechCrunch Disrupt, что компания больше не работает с Anthropic. Среди причин он назвал стоимость, условия партнёрства и результаты внутренних тестов. По словам руководителя, модели OpenAI лучше справляются с созданием приложений «с нуля» и дают Replit более сильный результат.
Однако считать это окончательным переходом Replit на OpenAI пока рано. В публичном поле остаются противоречивые сигналы: человек, знакомый с партнёрством Replit и Anthropic, оспорил заявление CEO, а инженерные материалы самой Replit и страница субподрядчиков указывают на сохранявшееся присутствие моделей Anthropic в инфраструктуре компании.
Эта неопределённость важнее самого спора двух поставщиков. Она показывает, как AI-модели превращаются из технологической основы в сменный компонент продукта — примерно как облачный провайдер, платёжный шлюз или система аналитики.
Почему «лучшая модель» — неправильный вопрос
Replit строит среду, в которой пользователь описывает задачу, а AI-агент планирует работу, пишет код, запускает тесты, подключает базы данных и разворачивает приложение. В такой системе модель не просто выдаёт текстовый ответ. Она участвует в длинной цепочке действий и может многократно обращаться к инструментам.
Поэтому сравнивать поставщиков только по качеству единичного ответа бессмысленно. Для бизнеса важнее стоимость завершённого сценария:
- сколько шагов потребовалось агенту;
- сколько раз он ошибся и повторил операцию;
- сколько токенов ушло на весь процесс;
- пришлось ли разработчику вручную исправлять результат;
- насколько часто система откатывает изменения;
- можно ли предсказуемо оценить время и себестоимость работы.
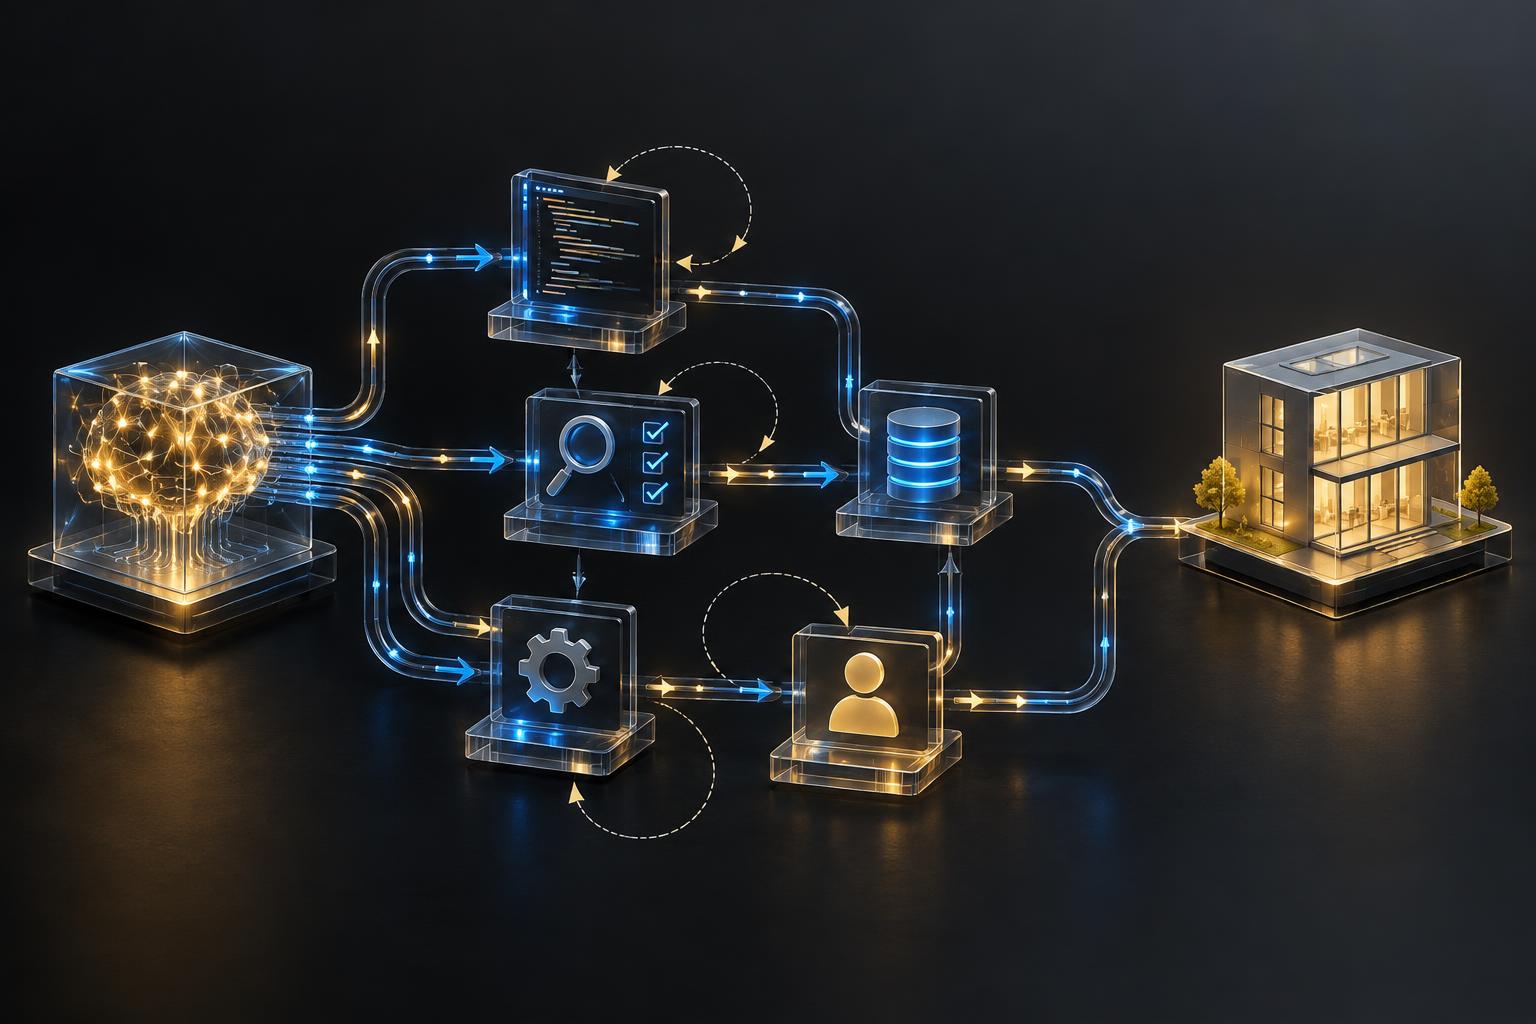
Модель, которая дешевле одного запроса, может оказаться дороже на уровне готового приложения, если чаще ломает интеграции или требует участия человека. И наоборот: более дорогой вызов способен улучшить маржинальность, если сокращает число повторных попыток и ручных исправлений.
Экономика полного рабочего процесса
Представим два AI-сервиса для генерации внутреннего веб-инструмента.
Первый использует дешёвую модель. Она быстро создаёт интерфейс, но ошибается в настройке базы данных, несколько раз перезапускает операции и оставляет разработчику час на проверку.
Второй сервис обращается к более дорогой модели. Та тратит больше вычислительных ресурсов на один шаг, зато с первого раза корректно подключает базу, пишет тесты и разворачивает приложение. Если пользователь платит за результат, а не за количество токенов, второй вариант может быть выгоднее для компании.
Именно такой сдвиг просматривается в инженерных материалах Replit. Компания описывала работу нескольких моделей в производственной среде и сравнивала не только ответы, но и то, как агенты распределяют задачи между вспомогательными исполнителями. Важным становился общий маршрут: сколько субагентов запускается, возвращается ли система к уже выполненной работе и как это влияет на итоговую стоимость.
Для предпринимателя это означает необходимость считать не «цену модели», а себестоимость пользовательского результата. В таблице закупок должны появиться показатели, которые раньше относились к операционному управлению: доля задач без вмешательства человека, число вызовов инструментов, среднее время до рабочего прототипа и валовая маржа на активного пользователя.
Почему публичное заявление не равно конфигурации продукта
В августе Replit объявила о сотрудничестве с OpenAI и запуске Free Mode на одной из моделей OpenAI. Это подтверждает расширение роли OpenAI в продукте, но само по себе не доказывает, что Anthropic исчез из всей технической инфраструктуры.
Публичная страница субподрядчиков Replit, обновлённая в августе 2026 года, также указывала Anthropic среди поставщиков AI-моделей. Возможны несколько объяснений: документация могла обновляться с задержкой, отдельные интеграции могли сохраниться, а слова «больше не работаем» могли относиться к конкретному коммерческому соглашению, а не ко всем техническим процессам.
Поэтому корректный вывод звучит осторожнее: CEO Replit публично объявил о прекращении сотрудничества, но открытые документы не позволяют установить точный масштаб и дату изменений. Это также не является независимым доказательством того, что одна модель в целом превосходит другую. Внутренние тесты компании могут быть хорошо подобраны под сценарии Replit и не переноситься на задачи другой организации.
Что нужно подготовить компаниям
1. Собственный набор тестов
Публичные бенчмарки полезны для первого сравнения, но не заменяют реальные задачи бизнеса. Интернет-магазину нужны тесты для каталога, заказов и возвратов. Финансовому сервису — для расчётов, разрешений и журналирования. Маркетинговой платформе — для сегментации, генерации вариантов и проверки брендовых ограничений.
Набор должен включать не только удачные сценарии, но и пограничные: неполные данные, конфликтующие инструкции, повторные изменения и отказ внешнего сервиса.
2. Возможность переключения
Архитектура продукта не должна зависеть от одного API настолько, чтобы смена модели требовала переписывать бизнес-логику. Желательно отделять слой работы с поставщиком от пользовательских сценариев, заранее проверять совместимость форматов и хранить историю результатов.
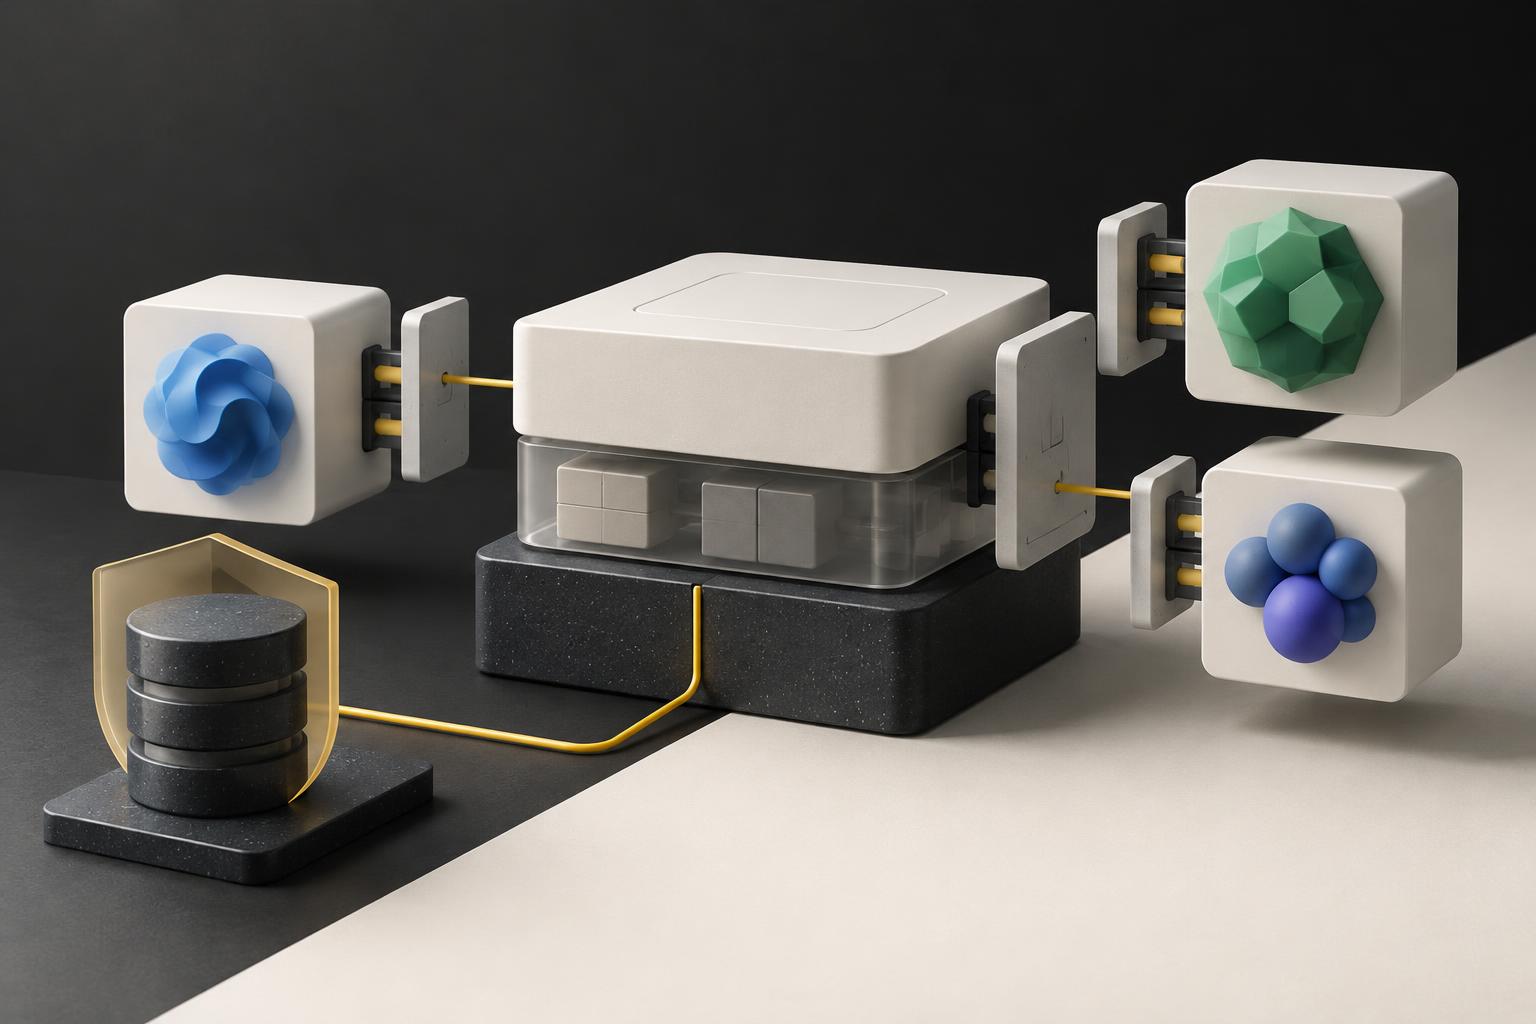
Быстрое переключение нужно не только на случай роста цены. Поставщик может изменить лимиты, правила хранения данных, доступность функций или поведение модели после обновления.
3. Контроль данных
Компаниям важно знать, какие модели обрабатывают пользовательский и корпоративный контент. Список субподрядчиков, условия хранения, режимы обучения на данных и география обработки должны быть частью закупочной проверки, а не формальностью после интеграции.
4. Метрики после запуска
Тестирование до релиза не гарантирует стабильность в production. Следует отслеживать стоимость полного workflow, частоту ошибок, ручные вмешательства и распределение запросов между моделями. Иначе поставщик может незаметно ухудшить экономику продукта, даже если качество ответов на отдельных примерах останется прежним.
Главный вывод
История Replit и Anthropic — не доказательство окончательной победы OpenAI и не простой сюжет о смене любимого поставщика. Это пример новой модели закупок: компании начинают выбирать AI не по универсальному рейтингу, а по стоимости и надёжности конкретного рабочего процесса.
Для бизнеса полезно заранее исходить из того, что модель может быть заменена. Собственные тесты, измерение стоимости готового результата, независимый слой интеграции и контроль над данными превращают зависимость от поставщика из стратегического риска в управляемую операционную задачу.


