От тестового API — к рабочему месту внутри лаборатории
Anthropic предоставила независимой организации METR доступ, близкий к уровню сотрудника компании. Шесть исследователей получили корпоративное оборудование, офисное пространство и возможность работать с внутренними системами и процессами оценки рисков. По замыслу сторон, METR сможет изучать не только поведение моделей в тестовом стенде, но и то, как AI-компания принимает решения о безопасности в реальной работе.
Для внешнего аудитора это заметный сдвиг. Обычно разработчик выдаёт ограниченный доступ к API, отдельной версии модели или заранее подготовленному набору данных. Исследователь проводит серию проверок, передаёт отчёт компании, а затем разработчик сам решает, что опубликовать.
В случае с METR заявлен другой режим: организация сможет самостоятельно публиковать результаты оценок, расследований инцидентов и анализа практик безопасности. Anthropic оставляет возможность ограничивать публикацию данных клиентов, материалов под юридической защитой и некоторых сведений об архитектуре моделей. При этом METR сможет описывать сам факт таких ограничений и объяснять их обоснованность.
Что именно меняет «доступ уровня сотрудника»
Условный внешний тест отвечает на вопрос: как модель ведёт себя в заданных сценариях?
Работа исследователя внутри компании позволяет задавать более широкий набор вопросов:
- какие инструменты получает модель и какие действия ей разрешены;
- кто и как меняет настройки безопасности;
- как фиксируются ошибки и опасные инциденты;
- какие журналы действий сохраняются;
- как устроены внутренние процедуры оценки перед запуском продукта;
- что происходит с проблемой после того, как её обнаружили.
Это особенно важно для AI-агентов. Их риск определяется не только ответом на запрос, но и возможностью самостоятельно обращаться к файлам, программам, корпоративным сервисам или внешним системам. Модель может выглядеть безопасной в диалоге, но при этом иметь слишком широкие полномочия в рабочей среде.
Поэтому проверять нужно не только содержание ответа, но и полный маршрут действия: какой запрос поступил, какие инструменты были доступны, какие команды выполнялись, что система записала в журнал и на каком этапе сработало ограничение.
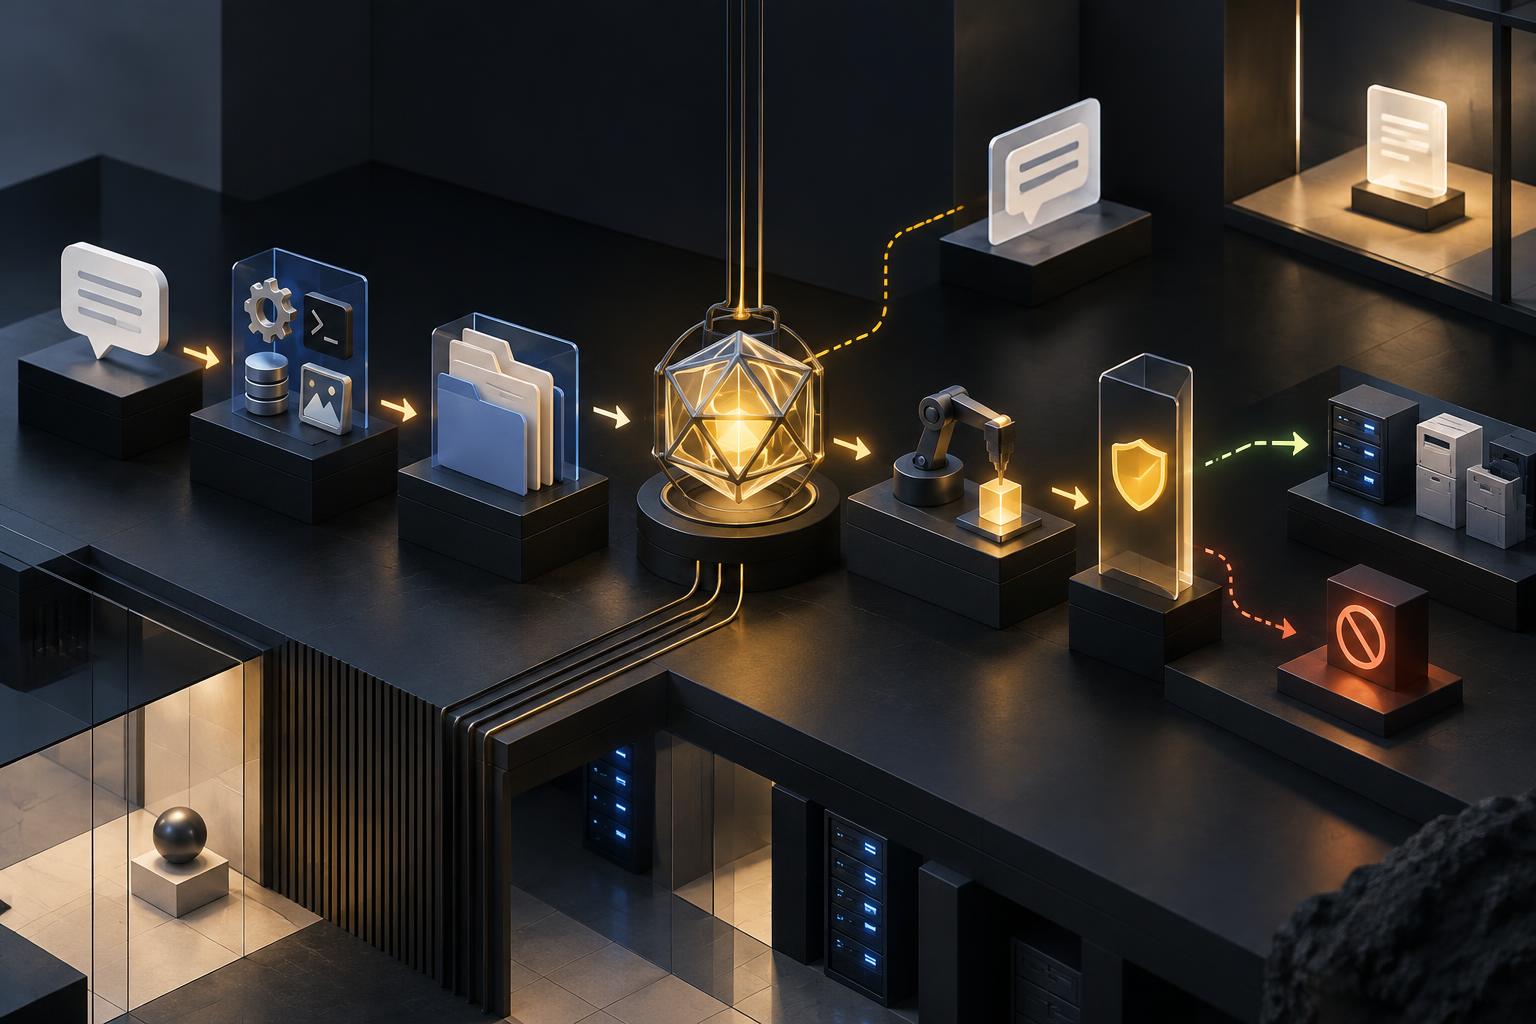
Как меняется проверка AI-агента: от ответа модели к полному маршруту действия.
Интерпретация: Anthropic испытывает формат постоянного технического наблюдения, напоминающий присутствие внешнего проверяющего внутри крупной организации. Это ближе к непрерывному контролю процессов, чем к разовой сертификации продукта.
Три уровня доступа
Anthropic описала трёхуровневую модель сотрудничества с внешними оценщиками.
Первый уровень: узкая проверка
Исследователь получает ограниченный доступ для конкретного расследования. Публикация результатов возможна только после согласования с компанией.
Второй уровень: расширенная оценка
Аудитор получает более широкий доступ и может публиковать выводы без предварительного разрешения, хотя компания сохраняет право требовать ограниченные изъятия информации.
Третий уровень: режим METR
Организация получает доступ, близкий к корпоративному, и самостоятельное право публиковать результаты. Именно этот вариант Anthropic представила как наиболее глубокий формат внешней оценки.
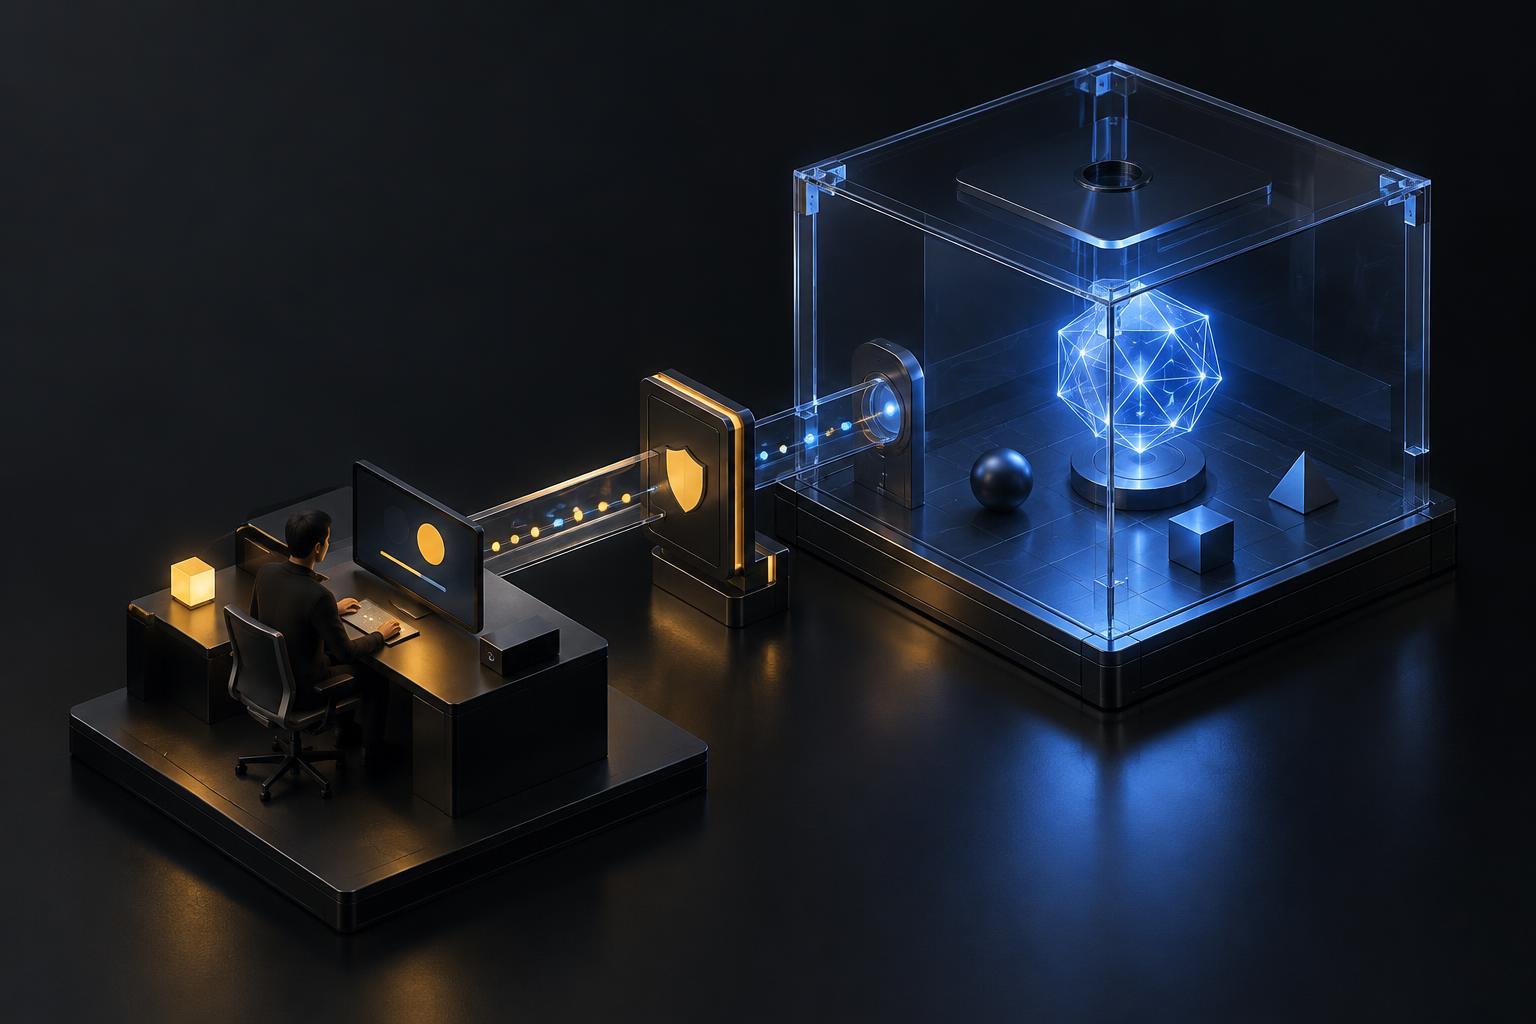
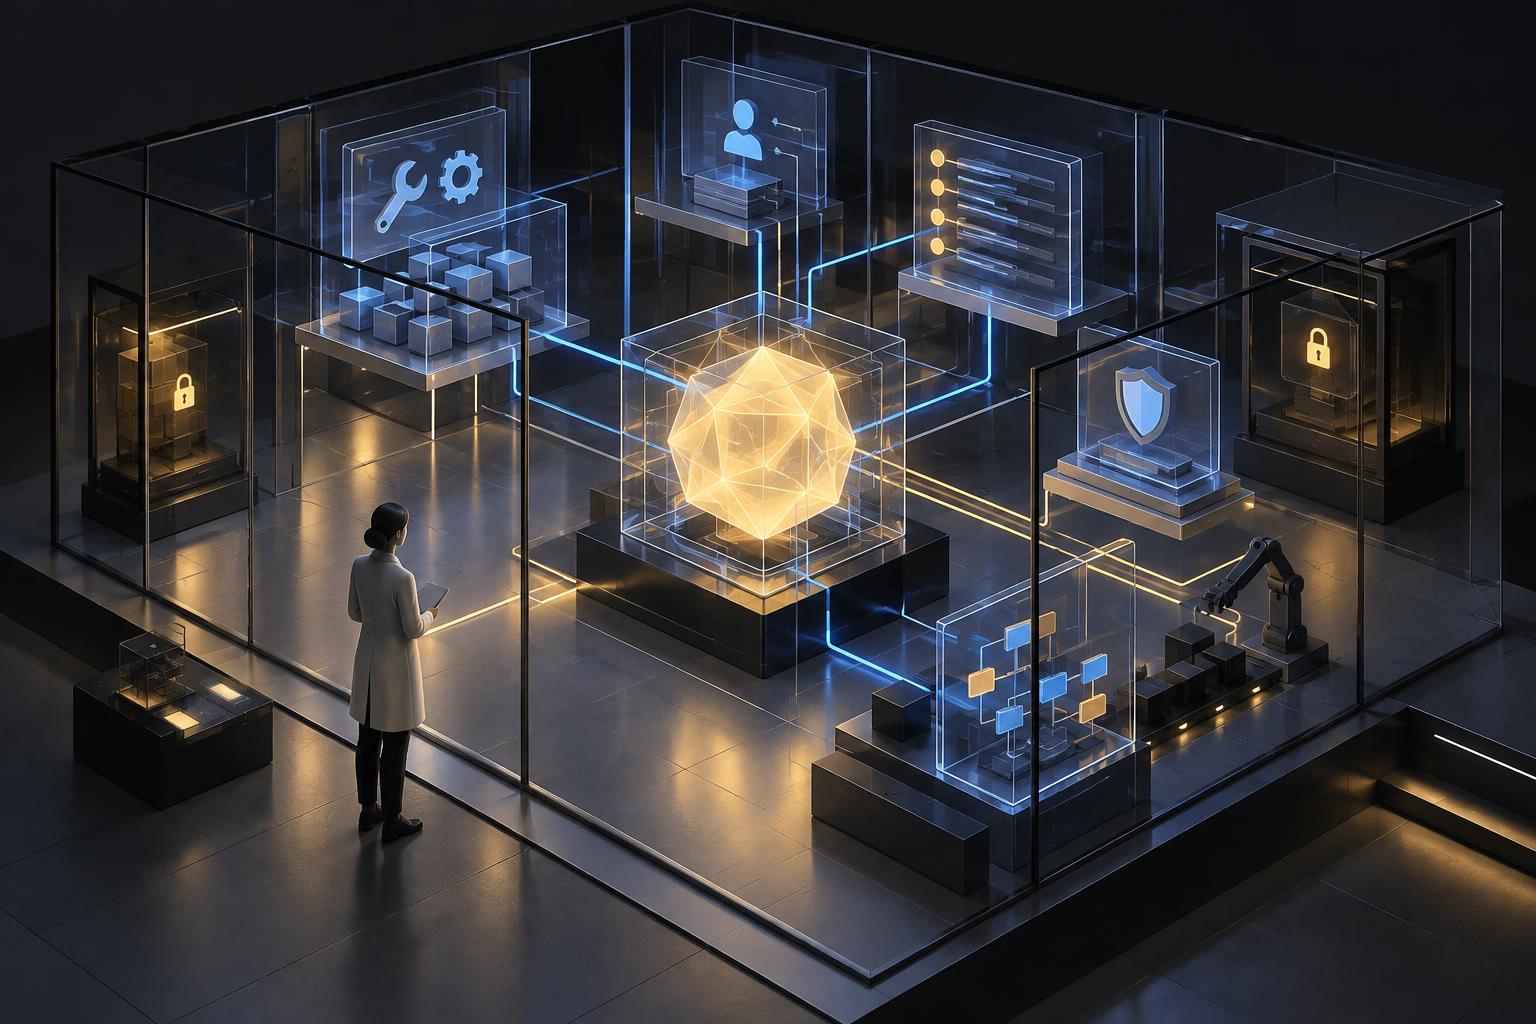
Два режима внешней оценки: ограниченный тест и доступ, близкий к работе внутри компании.
Важная оговорка: наличие трёх уровней не означает, что все внешние партнёры работают на одинаковых условиях. Anthropic также сотрудничает с SecureBio и развивает партнёрства с Accenture и AI-подразделением Faculty, однако условия доступа у этих организаций отличаются.
Почему это всё ещё не регулятор
Широкий доступ не превращает METR в государственный надзорный орган. Организация не получает автоматического права остановить запуск модели, потребовать изменения продукта или назначить штраф. Соглашение остаётся добровольным, а границы доступа в конечном счёте определяет сама Anthropic.
Зависимость от компании сохраняется и по другим причинам. Разработчик может не предоставить часть данных, отложить сотрудничество или прекратить его. Кроме того, между сторонами неизбежно возникает спор о границе между коммерческой тайной и сведениями, которые необходимы для оценки общественного риска.
У аудитора тоже есть сложный баланс интересов. Ему нужно сохранить доступ к будущим проверкам, но одновременно иметь возможность публично сообщать о серьёзных проблемах. Если организация слишком сильно зависит от одного поставщика, её независимость может оказаться формальной даже при наличии доступа к внутренним системам.
Пока опубликован сам факт нового режима, но нет итогового отчёта METR, который показал бы, какие проблемы удалось обнаружить и насколько свободно организация смогла ими распорядиться. Поэтому эффективность модели рано считать доказанной.
Что полезно проверить бизнесу
Компании, которые внедряют AI-агентов, могут использовать эту историю как практический чек-лист для оценки поставщиков.
1. Кто именно проводит проверку
Нужно отличать внутреннюю команду безопасности, нанятого консультанта и независимую исследовательскую организацию. У каждого формата разная степень автономии и разные стимулы.
2. Может ли аудитор публиковать выводы
Ключевой вопрос — требуется ли предварительное разрешение поставщика. Если компания может заблокировать любой неудобный результат, речь идёт скорее о контролируемом тестировании, чем о независимом аудите.
3. Что осталось за пределами проверки
Отчёт должен показывать не только найденные проблемы, но и ограничения доступа: какие модели, журналы, команды, документы и инциденты аудитор не видел.
4. Проверяются ли реальные действия
Надёжная оценка должна включать журналы событий, права доступа, историю изменений, аварийные остановки и реальные инциденты. Одних ответов модели в изолированном тестовом окружении недостаточно.
5. Есть ли повторная и независимая проверка
Один внешний аудитор не должен становиться единственным источником доверия. Разные команды могут по-разному оценить один и тот же риск, особенно если речь идёт о новых агентных возможностях.
Главный вывод
Anthropic сделала важный, но ограниченный шаг: пустила внешнюю организацию ближе к внутренней работе и отказалась от полного предварительного контроля над публикацией её выводов. Это сильнее обычного аудита по API и полезнее рекламного заявления о безопасности, потому что позволяет изучать не только модель, но и организационные процессы вокруг неё.
Но доступ не равен независимости, а независимость не равна полномочиям регулятора. Настоящая проверка такого подхода начнётся тогда, когда METR опубликует неудобный результат, а рынок увидит, может ли аудитор сохранить доступ и свободу действий после конфликта с поставщиком.
Для бизнеса вывод практический: при выборе AI-сервиса нужно спрашивать не только, насколько хорошо модель отвечает на запросы. Важно понимать, кто видит журналы действий, как расследуются инциденты, какие ограничения встроены в систему и имеет ли внешний проверяющий право рассказать о проблемах без разрешения самой AI-компании.


