Хороший контент не всегда доходит до нейросети
Компания может вложиться в экспертные статьи, техническое SEO, структурированные данные и подробные страницы товаров — и всё равно почти не появляться в ответах ChatGPT, Gemini и других систем. Причина иногда находится не в тексте и не в авторитетности домена, а между пользователем и сервером: в robots.txt, CDN или WAF.
Для обычного посетителя сайт может работать безупречно. Но автоматический запрос выглядит для инфраструктуры иначе: у него другой User-Agent, частота обращений, география и поведение. Система защиты может решить, что перед ней подозрительный бот, и вернуть не страницу, а отказ, проверку или урезанную версию контента.
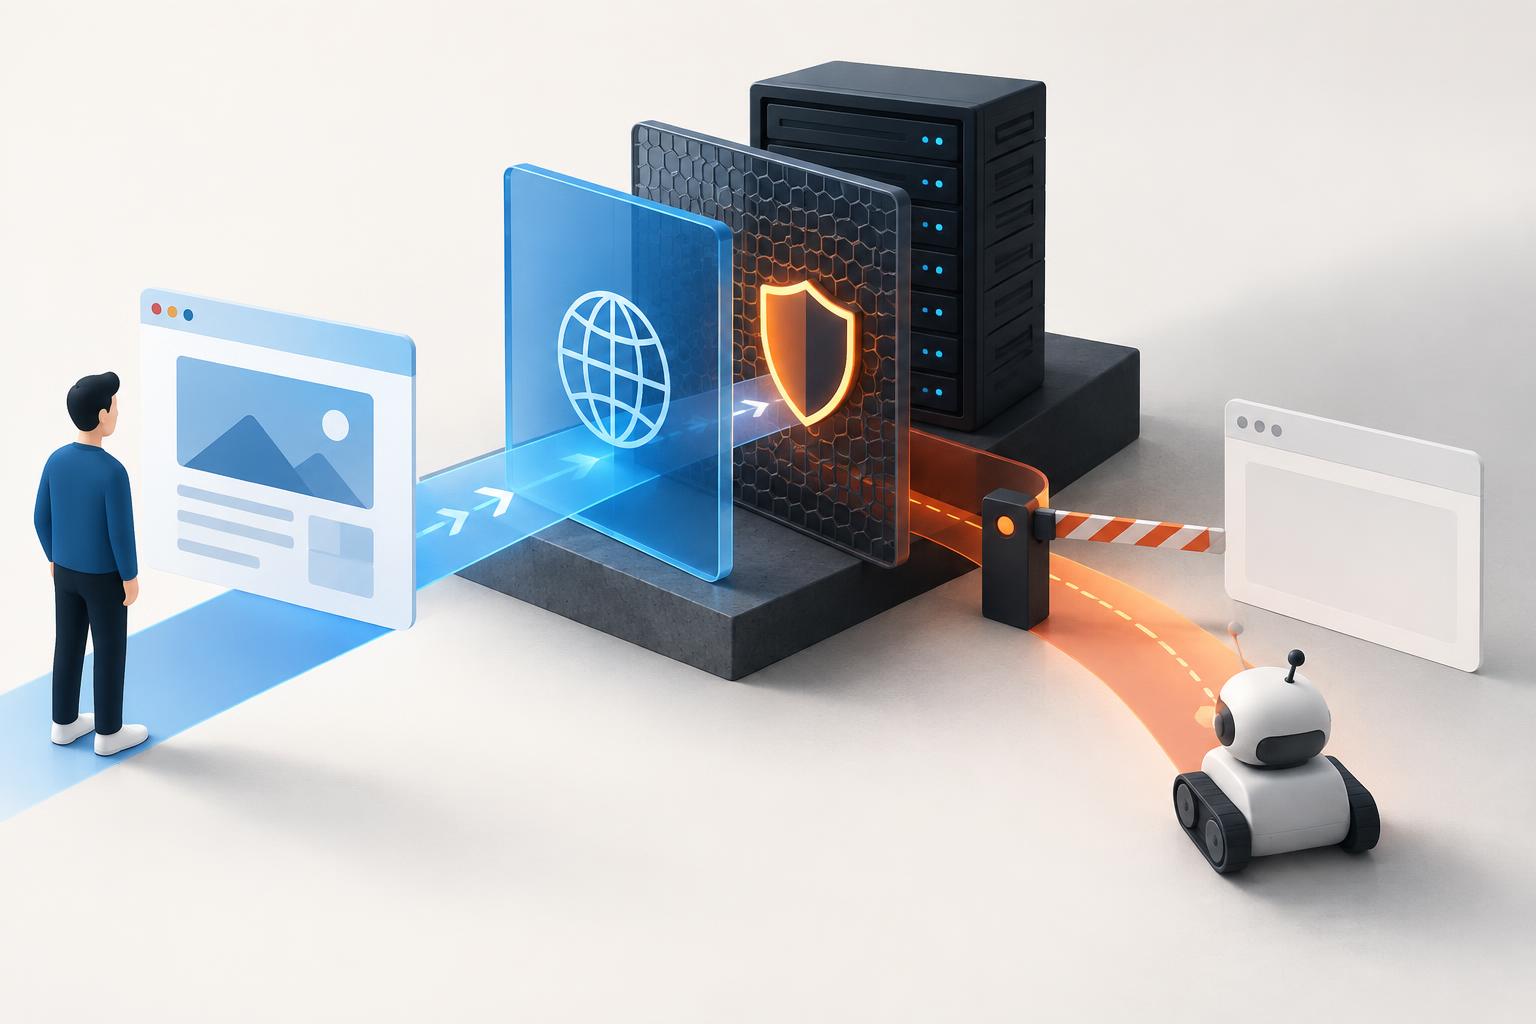
Как один и тот же сайт может быть доступен человеку, но недоступен автоматическому клиенту. Иллюстрация: ИИ
В таком случае команда продолжает улучшать материалы, которые AI-система фактически не может прочитать.
AI-трафик больше нельзя считать одной категорией
Одна из главных ошибок в работе с AI-видимостью — считать любого бота одинаковым. На практике у автоматического доступа могут быть разные цели.
1. Поисковая индексация
Бот читает страницу, чтобы использовать её как источник для ответа или направить пользователя на сайт. Для бизнеса это наиболее близкий аналог традиционного поискового обхода.
Например, AI-система анализирует карточку тарифа, сравнивает условия нескольких сервисов и упоминает компанию в итоговом ответе. Если бот не получил HTML, цены и описание продукта, сайт просто не попадёт в поле сравнения.
2. Действия агента
Агент действует от имени пользователя: ищет товар, подбирает услугу, проверяет наличие, сравнивает доставку или пытается перейти к оформлению заказа.
Такой сценарий требует более широкого доступа и несёт больше рисков. Разрешить чтение каталога — не то же самое, что разрешить автоматическому агенту проходить корзину, личный кабинет или платёжный путь.
3. Обучение моделей
Контент может забираться для обучения или дообучения модели. Это отдельная цель, которую бизнес вправе рассматривать иначе, чем поисковую индексацию.
Медиа может хотеть, чтобы его публикации находились в ответах на актуальные вопросы, но не соглашаться на массовое использование архива для обучения. Производитель может открыть публичную документацию для поиска, но ограничить её переработку в обучающих наборах.
Эти сценарии не следует объединять одним правилом «разрешить AI-ботов».
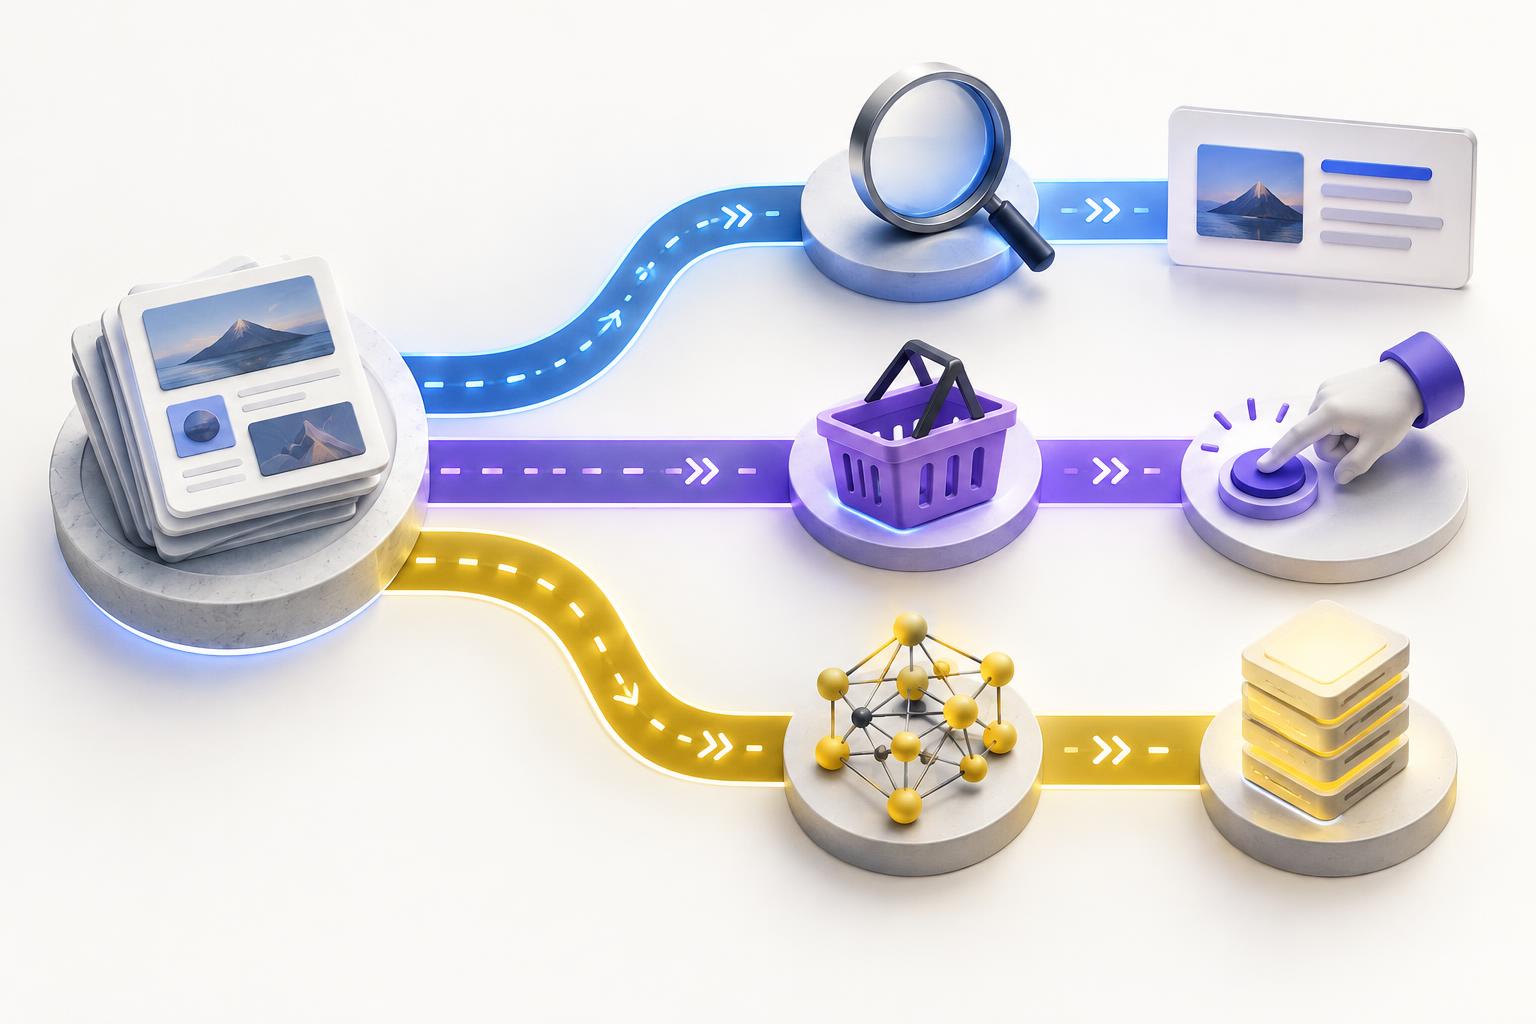
У AI-доступа могут быть разные цели: поиск, действия агента и обучение моделей. Иллюстрация: ИИ
Что делают CDN и WAF
robots.txt задаёт предпочтения владельца сайта: какие роботы и разделы можно обходить. Но это не технический замок. Добросовестные краулеры учитывают файл, однако фактический доступ всё равно определяется сервером, CDN и WAF.
CDN может фильтровать запросы до того, как они попадут на исходный сервер. WAF анализирует поведение, заголовки, частоту обращений и другие признаки. В результате AI-боту могут вернуть:
- код 403 или другой отказ в доступе;
- страницу с CAPTCHA или JavaScript-проверкой;
- временную заглушку вместо контента;
- HTML без важных данных, которые подгружаются отдельным запросом;
- устаревшую копию страницы из кэша.
Для человека это иногда незаметно: браузер проходит проверку автоматически, а бот — нет. Поэтому проверка сайта только из обычного браузера не показывает реальную AI-доступность.
По предварительному анализу трафика в одной из крупных CDN-сетей, в третьем квартале 2026 года отказ получали 13,47% запросов AI-ботов против 5,98% годом ранее. Это не показатель всего интернета: речь идёт об одной инфраструктурной сети и конкретной методике подсчёта. Но направление показательно — системы защиты всё чаще различают не только человека и машину, но и предполагаемую цель запроса.
Мониторинги robots.txt также фиксируют заметную долю сайтов, которые ограничивают хотя бы одного AI-краулера. Их цифры нельзя складывать: у сервисов разные выборки, наборы роботов и определения блокировки. Однако для бизнеса вывод практический: запрет может появиться задолго до того, как команда заметит падение упоминаний в AI-ответах.
Почему маркетинговый аудит иногда ищет проблему не там
Представим интернет-магазин, который почти не упоминается в ответах нейросетей. Команда переписывает описания, добавляет FAQ, публикует обзоры и размечает товары структурированными данными.
Но WAF возвращает краулеру страницу проверки. Все улучшения остаются невидимыми для системы, которая должна была их проиндексировать. Маркетинговый бюджет расходуется на контент, а узкое место находится в настройках безопасности.
Возможна и обратная ситуация: компания открывает доступ всем типам ботов, не определив границы. Тогда вместе с публичными материалами могут стать доступными устаревшие цены, служебная документация, тестовые страницы или данные, которые нельзя свободно перерабатывать.
Чек-лист технического аудита
Перед запуском AI-SEO стоит проверить сайт по отдельным сценариям.
Доступ к поиску
- Какие AI-боты получают полноценный ответ сервера.
- Видят ли они HTML, заголовки, канонические URL и структурированные данные.
- Не заменяет ли CDN страницу контентом-заглушкой.
- Совпадают ли правила
robots.txtс настройками WAF и CDN.
Доступ для агентов
- Может ли агент читать каталог, документацию и условия доставки.
- Закрыты ли корзина, личный кабинет, формы оплаты и внутренние API.
- Есть ли отдельные правила для просмотра и совершения действий.
- Как система фиксирует и ограничивает автоматические операции.
Доступ для обучения
- Разрешено ли использование публичных материалов для обучения моделей.
- Какие разделы исключены из этого сценария.
- Не смешиваются ли настройки обучения с поисковой индексацией.
- Согласованы ли правила между IT, безопасностью, маркетингом и юридической командой.
Тестировать нужно не только главную страницу, но и типовые карточки товаров, статьи, документацию, страницы с ценами и разделы, которые должны оставаться закрытыми. Важно смотреть не на то, как сайт выглядит в браузере, а на фактический ответ сервера для разных типов запросов.
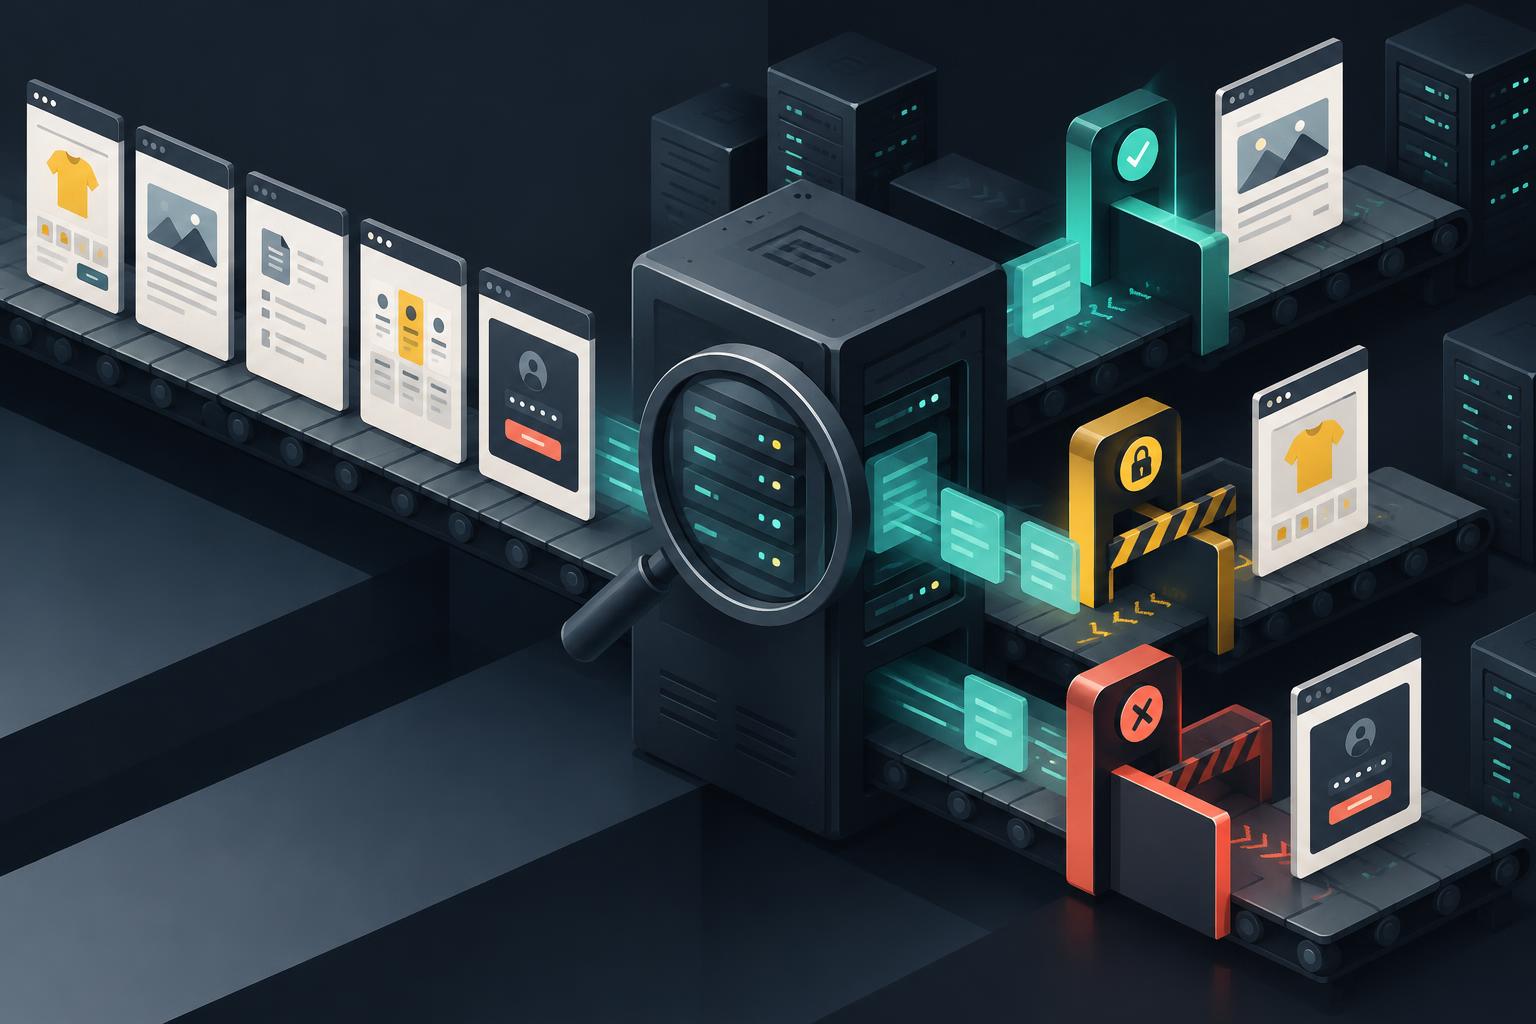
Технический аудит проверяет не только контент, но и фактический ответ сервера для разных типов запросов. Иллюстрация: ИИ
Главный вывод
AI-видимость — это не новый слой копирайтинга поверх SEO. Это результат работы контента, инфраструктуры и политики доступа одновременно.
Сайт может быть понятным для поисковой модели, но закрытым для агента. Может разрешать индексацию и запрещать обучение. Может выглядеть доступным для человека и возвращать WAF-проверку автоматическому клиенту.
Поэтому первый вопрос бизнеса должен звучать не «как написать текст, который понравится нейросети», а «кто, зачем и на каких условиях может прочитать наш сайт». Только после этого имеет смысл измерять упоминания бренда и улучшать контент.


