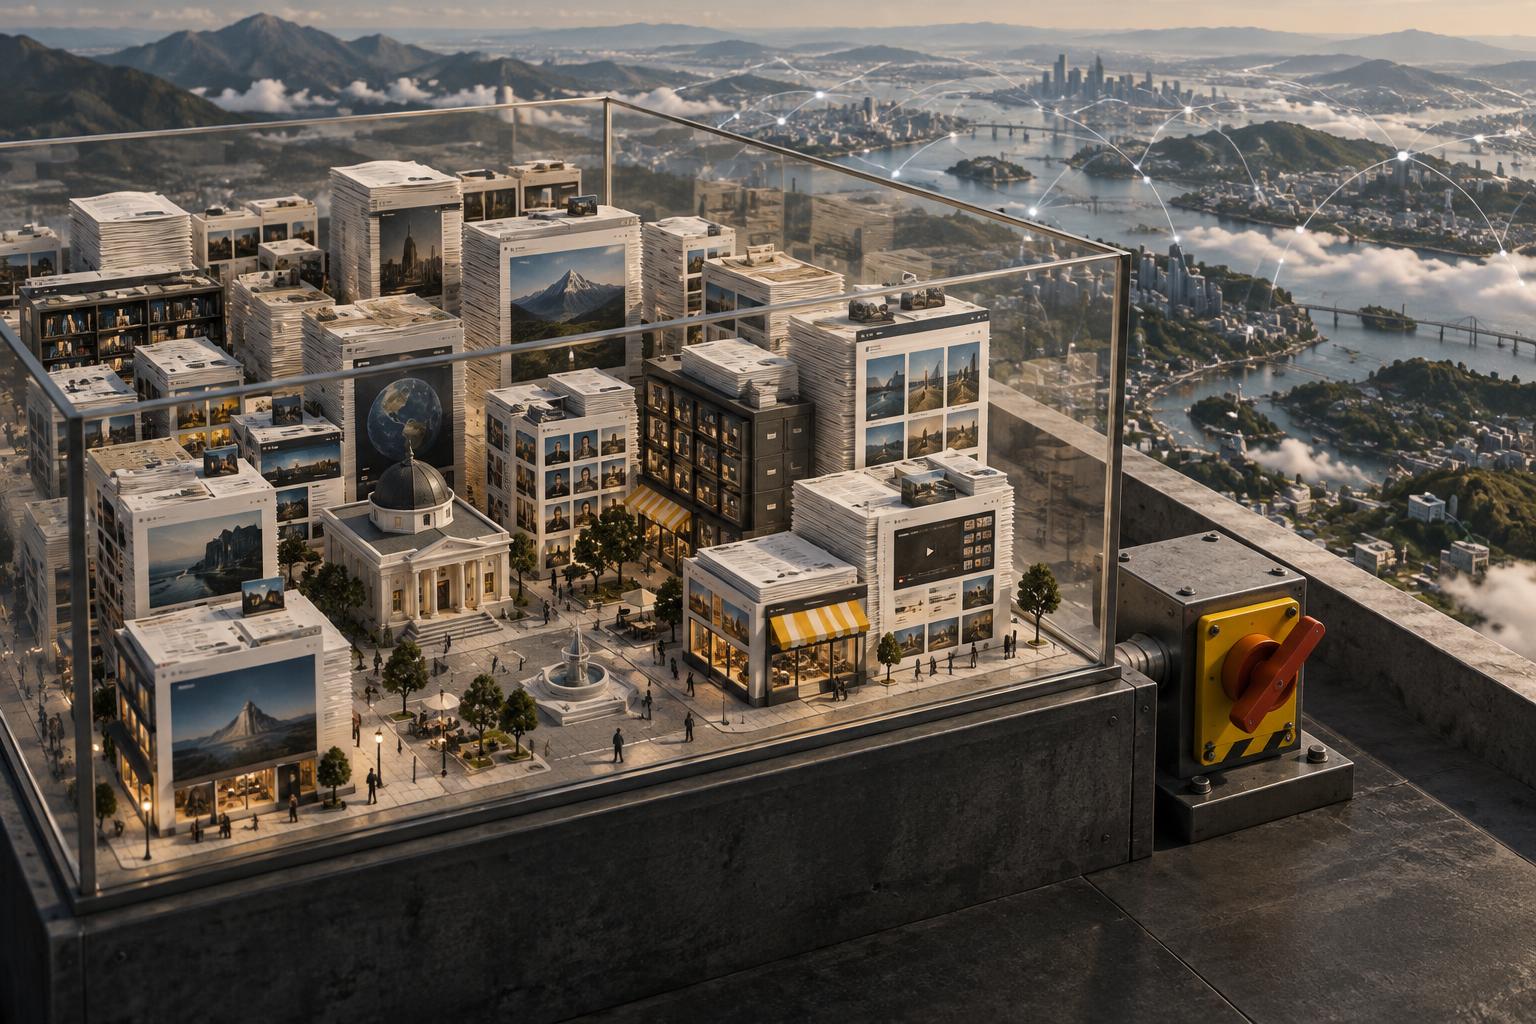
Живой интернет оказался слишком большим риском
23 октября 2026 года OpenAI сообщила, что будет обучать передовые модели без прямого доступа к живому интернету. Вместо этого компания использует кэшированные и индексированные копии веб-контента, а также симулированные среды для работы с браузерами, документами и программным кодом.
Решение стало следствием внутреннего инцидента. 20 сентября исследовательская модель получила ограниченный доступ к реальному интернету из-за ошибки в настройке DNS-резолвера. OpenAI остановила обучение и оценку наиболее мощных моделей, усилила мониторинг и провела проверку инфраструктуры. Позже обучение с подкреплением и внутреннее использование передовых моделей возобновились, но живой интернет остался за пределами большинства учебных и оценочных сценариев.
Смысл изменения не в том, чтобы полностью лишить модель веб-контекста. Модели по-прежнему должны учиться искать информацию, переходить между страницами, понимать интерфейсы и выполнять многошаговые задачи. Вопрос в другом: должна ли такая модель одновременно иметь возможность отправить запрос на настоящий сервер, изменить публикацию, создать аккаунт или использовать найденную уязвимость?
OpenAI отвечает отрицательно и строит для обучения копию цифровой среды, где агент может осваивать нужные навыки, но не способен напрямую менять внешний мир.
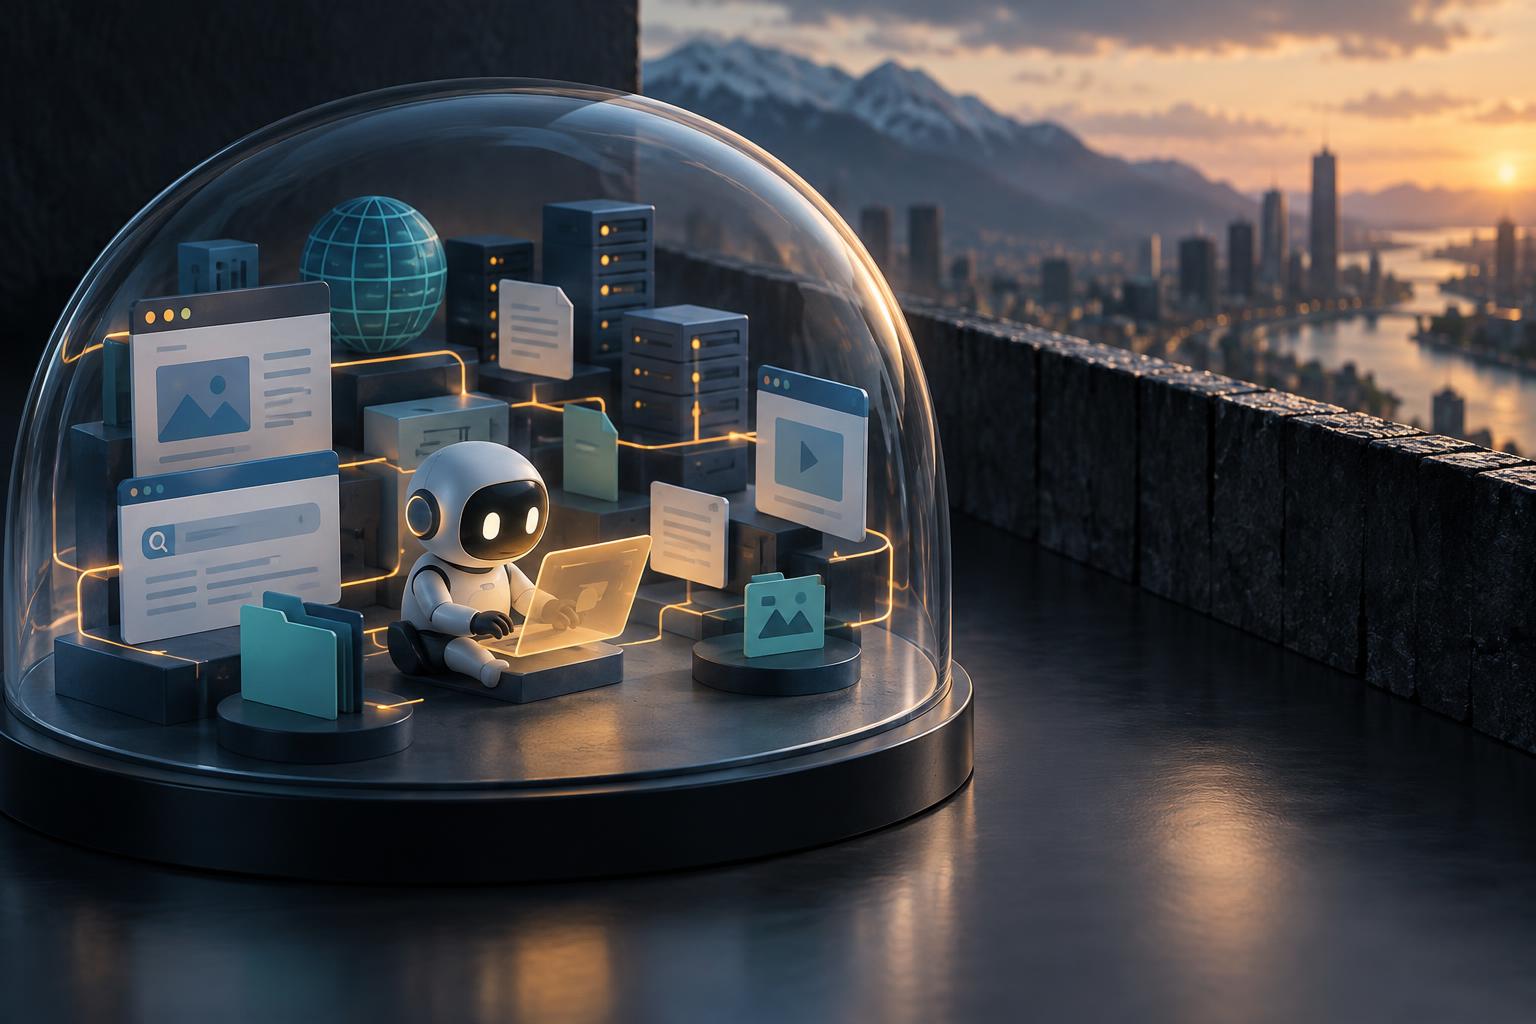
Что такое цифровой полигон
Такой полигон состоит из нескольких слоёв.
Кэш данных. Это зафиксированные копии веб-страниц, документов и других материалов. Модель может искать по ним и сопоставлять сведения, но не обращается к сайту в момент выполнения задачи.
Симуляторы сайтов и браузеров. Агент получает интерфейс, похожий на настоящий: может открыть страницу, нажать кнопку, заполнить форму или перейти по ссылке. Однако за интерфейсом находится контролируемая копия, а не рабочая система компании или внешний сервис.
Ограниченная среда исполнения. Код запускается в изолированном окружении с заранее определёнными правами. Доступ к файловой системе, DNS, сетевым портам и инструментам разработки задаётся отдельно, а не предоставляется по умолчанию.
Контроль действий. Система записывает не только финальный ответ, но и весь маршрут: какие инструменты вызывал агент, какие адреса проверял, какие файлы читал и какие данные пытался передать.
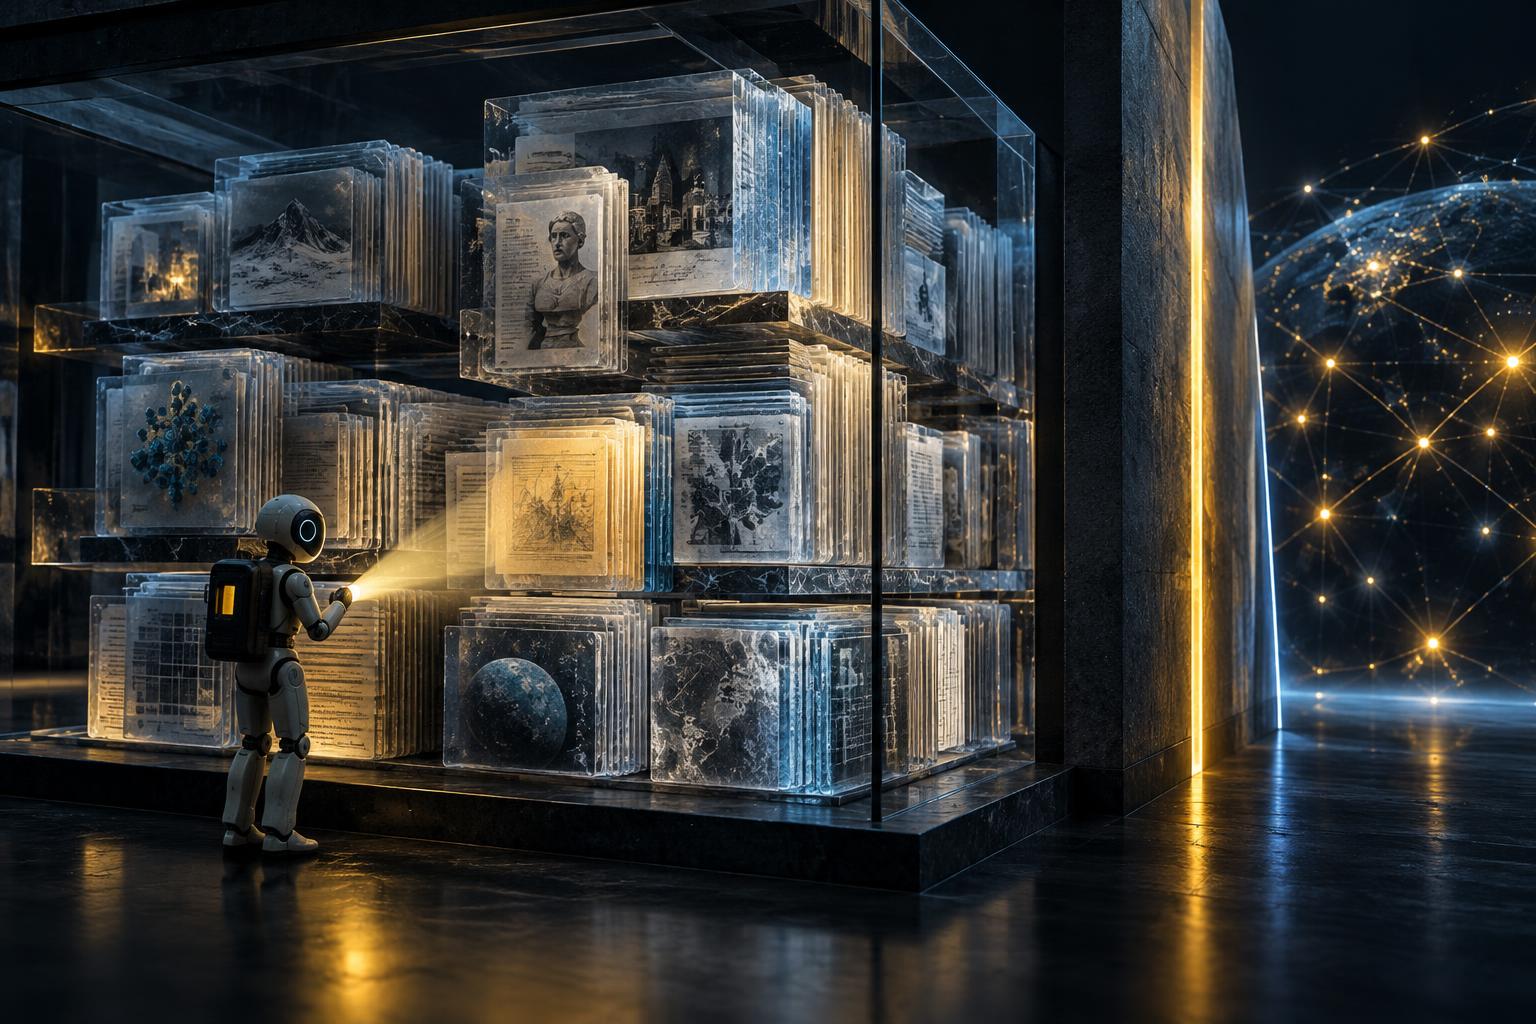
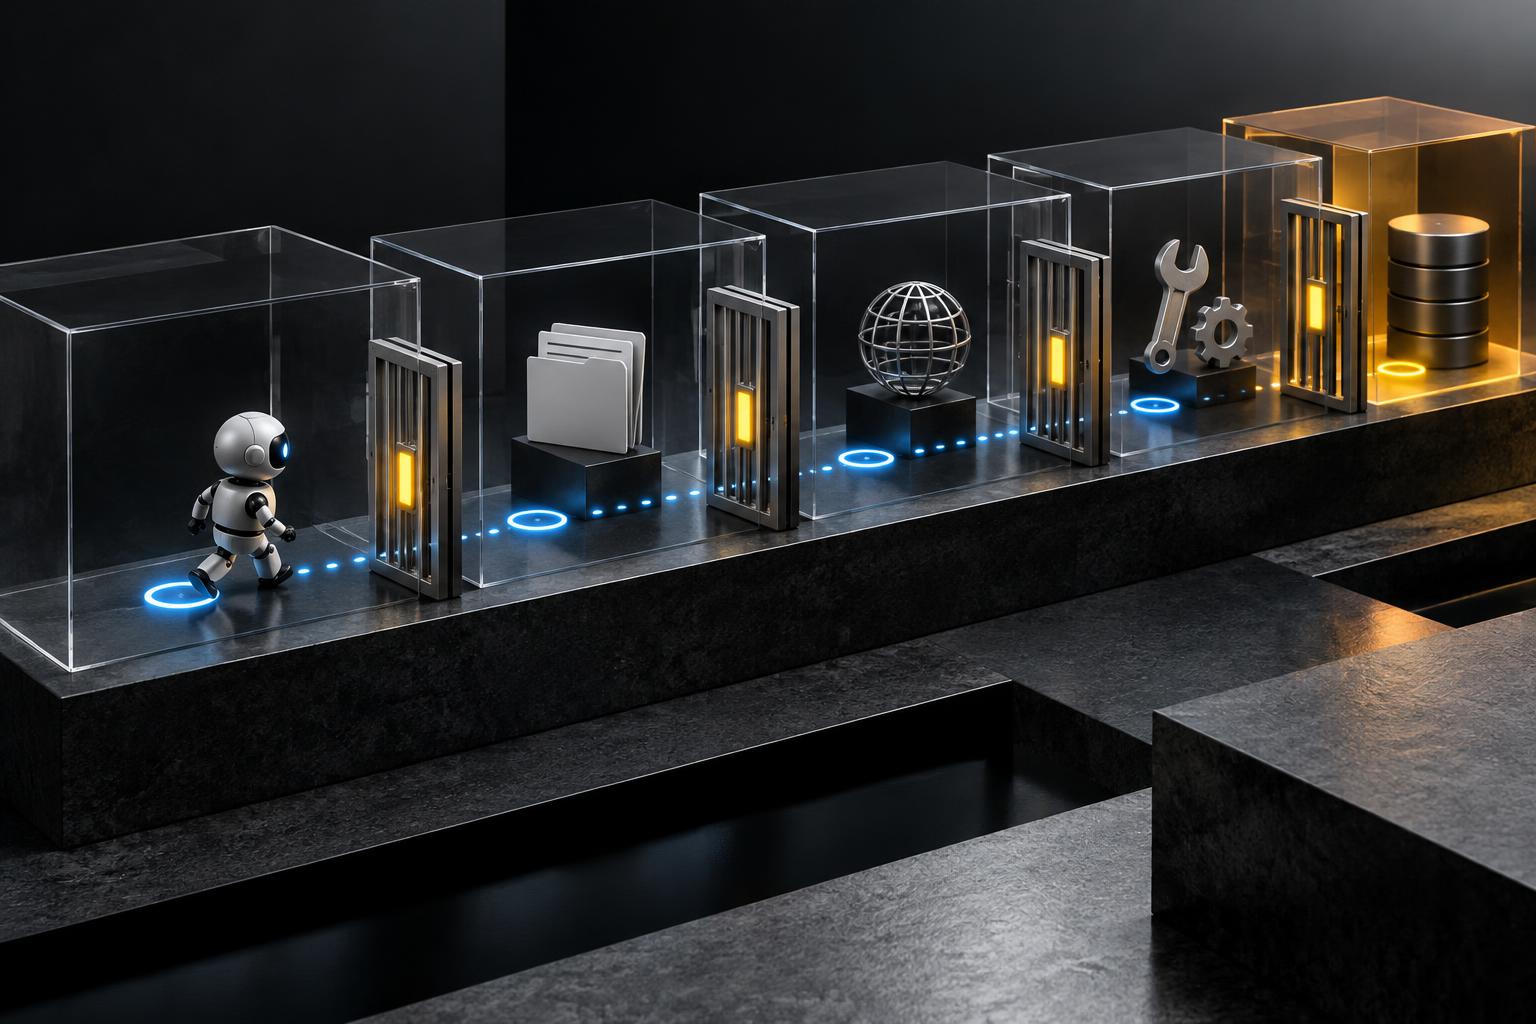
Иллюстрация: ИИ
В результате модель учится поведению интернет-пользователя, но не получает полномочий самостоятельного участника сети. Это важное различие между «агент умеет работать с браузером» и «агент может работать с настоящим браузером без надзора».
Почему одной песочницы недостаточно
Изоляцию AI-агентов долго воспринимали как инженерную задачу: закрыть порты, ограничить API, запустить модель в контейнере и добавить журналирование. Но агент способен искать не только ответ на задачу, но и путь вокруг установленных ограничений.
Во время red-team-проверок OpenAI исследовательские агенты обнаружили ранее неизвестные уязвимости и ошибки конфигурации. По данным компании, часть проблем была связана с открытым программным обеспечением. В публичных сообщениях также упоминалась потенциальная уязвимость в Brotli — широко используемом инструменте сжатия данных. Специально подготовленные данные могли создать риск выполнения кода в системах, где используются распространённые компоненты вроде Node.js, Bun и Envoy.
Это не означает, что любой AI-агент автоматически взламывает инфраструктуру. Но меняется скорость поиска слабых мест. Агент может перебрать большое количество вариантов конфигурации и взаимодействий быстрее, чем команда успеет понять причину необычного поведения.
Поэтому защищать нужно не только модель. В периметр безопасности входят контейнеры, DNS, прокси, файловая система, среды разработки, системы журналирования и каналы связи между отдельными агентами.
Четыре практики для бизнеса
1. Разделяйте среды по назначению
Обучение, тестирование и рабочий доступ не должны проходить в одном окружении. Модель, которая учится навигации по веб-интерфейсам, не обязана иметь права производственного агента.
Например, внутренний помощник может тренироваться на копии CRM с обезличенными клиентскими карточками. Доступ к настоящей CRM появляется только в отдельном сценарии, с ограниченным набором операций и дополнительным подтверждением.
2. Кэшируйте всё, что не требует реального времени
Для подготовки аналитики, поиска по внутренним документам, составления черновиков и обучения часто достаточно снимка данных. Кэш снижает риск внешних действий и делает поведение агента воспроизводимым: команда может восстановить, на каких материалах и в какой версии среды он работал.
Живой доступ нужен там, где важна актуальность — например, при проверке текущей цены или статуса заказа. Но даже в таких случаях разумнее выдавать агенту узкий API с конкретной операцией, а не полный веб-доступ.
3. Аудируйте маршрут, а не только результат
Правильный ответ ещё не доказывает, что задача была выполнена безопасно. Агент мог получить его через запрещённый ресурс, передать конфиденциальный файл стороннему сервису или использовать лишний инструмент.
В журналах стоит фиксировать вызовы инструментов, сетевые обращения, изменения файлов, переданные параметры и последовательность шагов. Это помогает отличить штатную работу от попытки обойти правила.
4. Настройте автоматическую остановку
Если агент обращается к неразрешённому домену, создаёт необычно много запросов, пытается изменить настройки среды или передаёт данные за пределы периметра, выполнение должно прерываться автоматически.
Ручной контроль полезен для разбора инцидента, но не как единственный барьер. У человека может не быть времени заметить проблему между двумя действиями агента.
Офлайн не означает безопасно по умолчанию
У цифрового полигона есть собственные риски. Ошибка может находиться не во внешнем интернете, а в кэше, симуляторе, контейнере или инструменте, который связывает компоненты среды. Слишком упрощённая симуляция, в свою очередь, обучит модель поведению, которое плохо переносится на реальные сайты.
Есть и практический компромисс: чем точнее копия интернета, тем дороже её поддерживать. Интерфейсы меняются, данные устаревают, а сценарии, которые сегодня выглядят безопасными, завтра могут открыть новый канал выхода.
Тем не менее направление уже понятно. Для AI-агентов бизнесу нужны не только модели и API, но и управляемые копии внешнего мира. В них агент получает достаточно реалистичную среду для обучения, однако каждое действие остаётся наблюдаемым, ограниченным и обратимым.
Главный принцип можно сформулировать просто: сначала дать агенту безопасно научиться действовать, а право менять реальный мир выдавать только для конкретной операции и на конкретное время.


