GPU ускоряет ответ, но не всегда всю задачу
Рынок AI-инфраструктуры долго измерял производительность количеством ускорителей, объёмом видеопамяти и скоростью генерации токенов. Для чат-бота такая логика ещё работает: пользователь отправляет запрос, модель обрабатывает его на GPU и формирует ответ.
AI-агент устроен иначе. Он может вызвать API, найти данные в базе, запустить фрагмент кода, создать файл, проверить результат и повторить операцию. Между двумя обращениями к модели происходит много работы, за которую отвечают обычные серверные компоненты — прежде всего CPU, память, сеть и система изоляции процессов.
В результате модель может генерировать токены быстрее, но задача пользователя всё равно будет выполняться медленно. Причина — не в самой нейросети, а в очереди операций вокруг неё.
Что показал тест Modal
Облачная AI-компания Modal сообщила о тестировании серверов на процессоре Nvidia Vera. В её инфраструктуре запускаются изолированные песочницы — контейнеры и виртуальные машины, где AI-приложения могут безопасно выполнять код.
По данным Modal, после перехода на Vera пропускная способность в ранних тестах выросла примерно вдвое по сравнению с использовавшимися ранее процессорами Intel и AMD. Компания подчеркнула, что на одном узле одновременно работают сотни изолированных сред, причём каждая создаёт собственный профиль нагрузки.
Это важная деталь. Сервер для AI-агентов обслуживает не один длинный вычислительный процесс, а множество коротких и непредсказуемых операций: запуск команды, обращение к файловой системе, сетевой запрос, создание контейнера, чтение результата и новый вызов модели. Здесь важны не только общее число ядер, но и задержка отдельных действий, скорость переключения между задачами и стабильность при конкуренции за ресурсы.
Modal не заявляла об отказе от Intel и AMD. Напротив, компания планирует смешанную инфраструктуру, где разные нагрузки будут направляться на наиболее подходящие процессоры.
Агент — это цепочка, а не один вызов модели
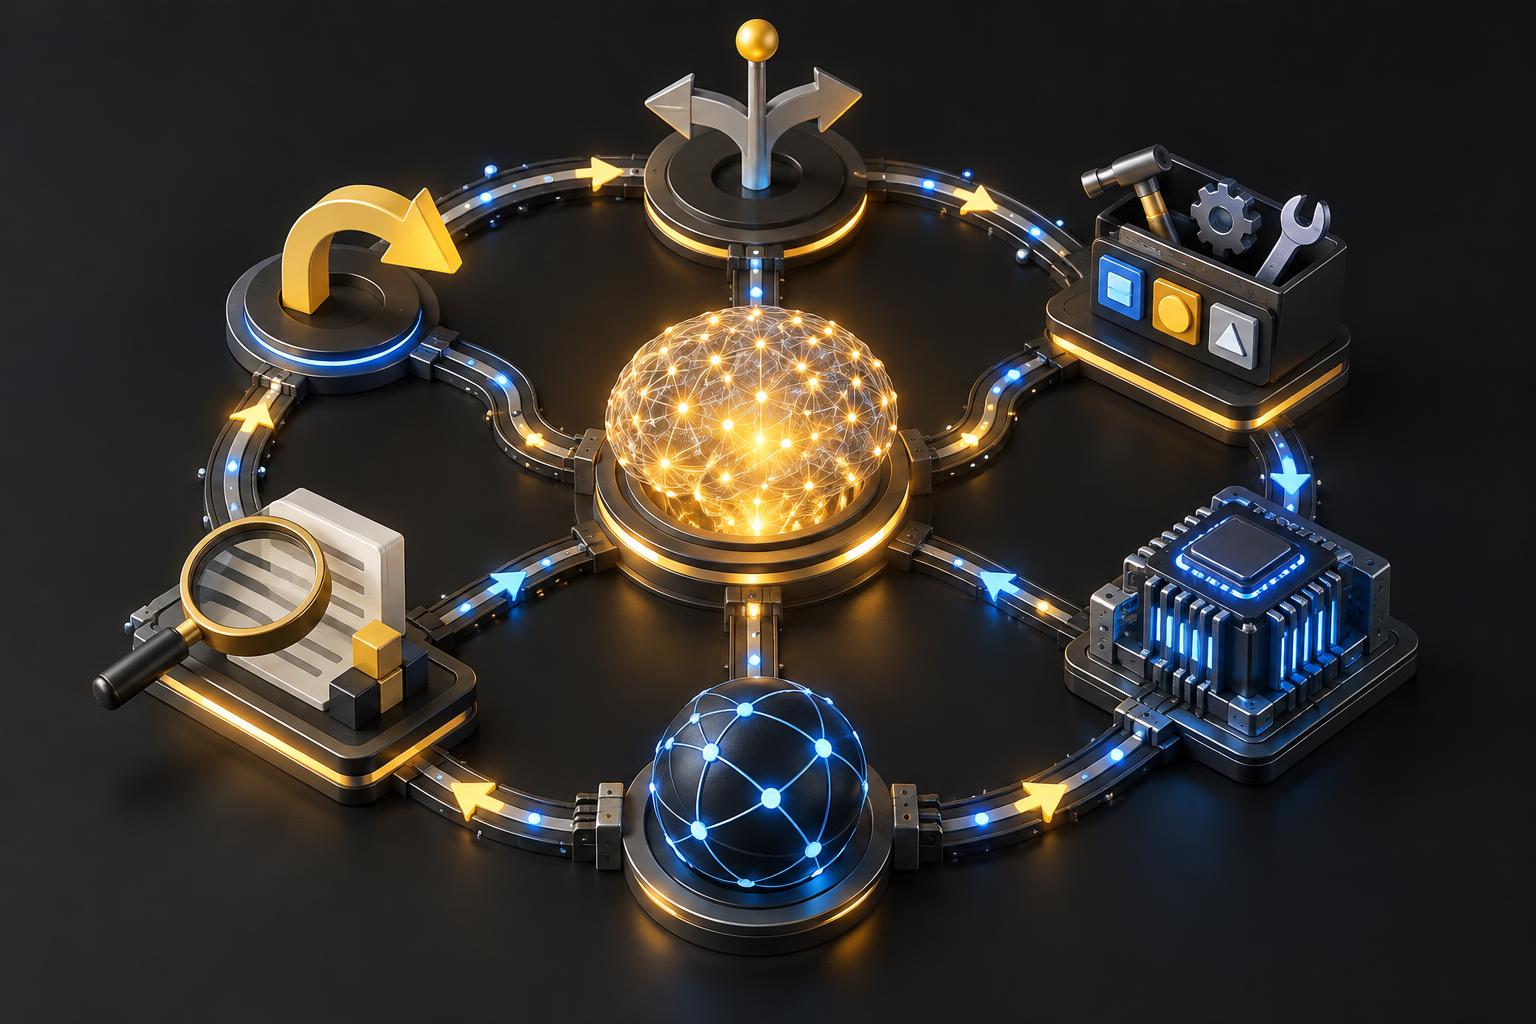
Упрощённый сценарий работы агента выглядит так:
- модель анализирует задачу;
- выбирает инструмент;
- CPU запускает код или сетевой запрос;
- система возвращает результат;
- модель проверяет его и принимает следующее решение;
- цикл повторяется до завершения задачи.
GPU особенно эффективен там, где нужно параллельно обработать большие массивы данных. Но запуск процесса, управление контейнерами, оркестрация инструментов и обмен с внешними сервисами обычно ложатся на CPU.
Исследование A CPU-Centric Perspective on Agentic AI рассматривало несколько агентных сценариев, включая RAG, LangChain и SWE-Agent. Авторы обнаружили, что обработка инструментов на CPU в отдельных нагрузках занимала до 90,6% общей задержки. Это не универсальный показатель для любого продукта, но он хорошо показывает проблему: ускорение инференса не гарантирует пропорционального ускорения агента.
Представим сервис, который помогает разработчику исправить ошибку. Модель предлагает патч за доли секунды, но затем агент должен создать рабочую среду, установить зависимости, запустить тесты, прочитать логи и повторить попытку. Если каждая такая операция добавляет задержку, пользователь будет ждать не генерацию текста, а завершение всей цепочки.
Nvidia продаёт не только процессор
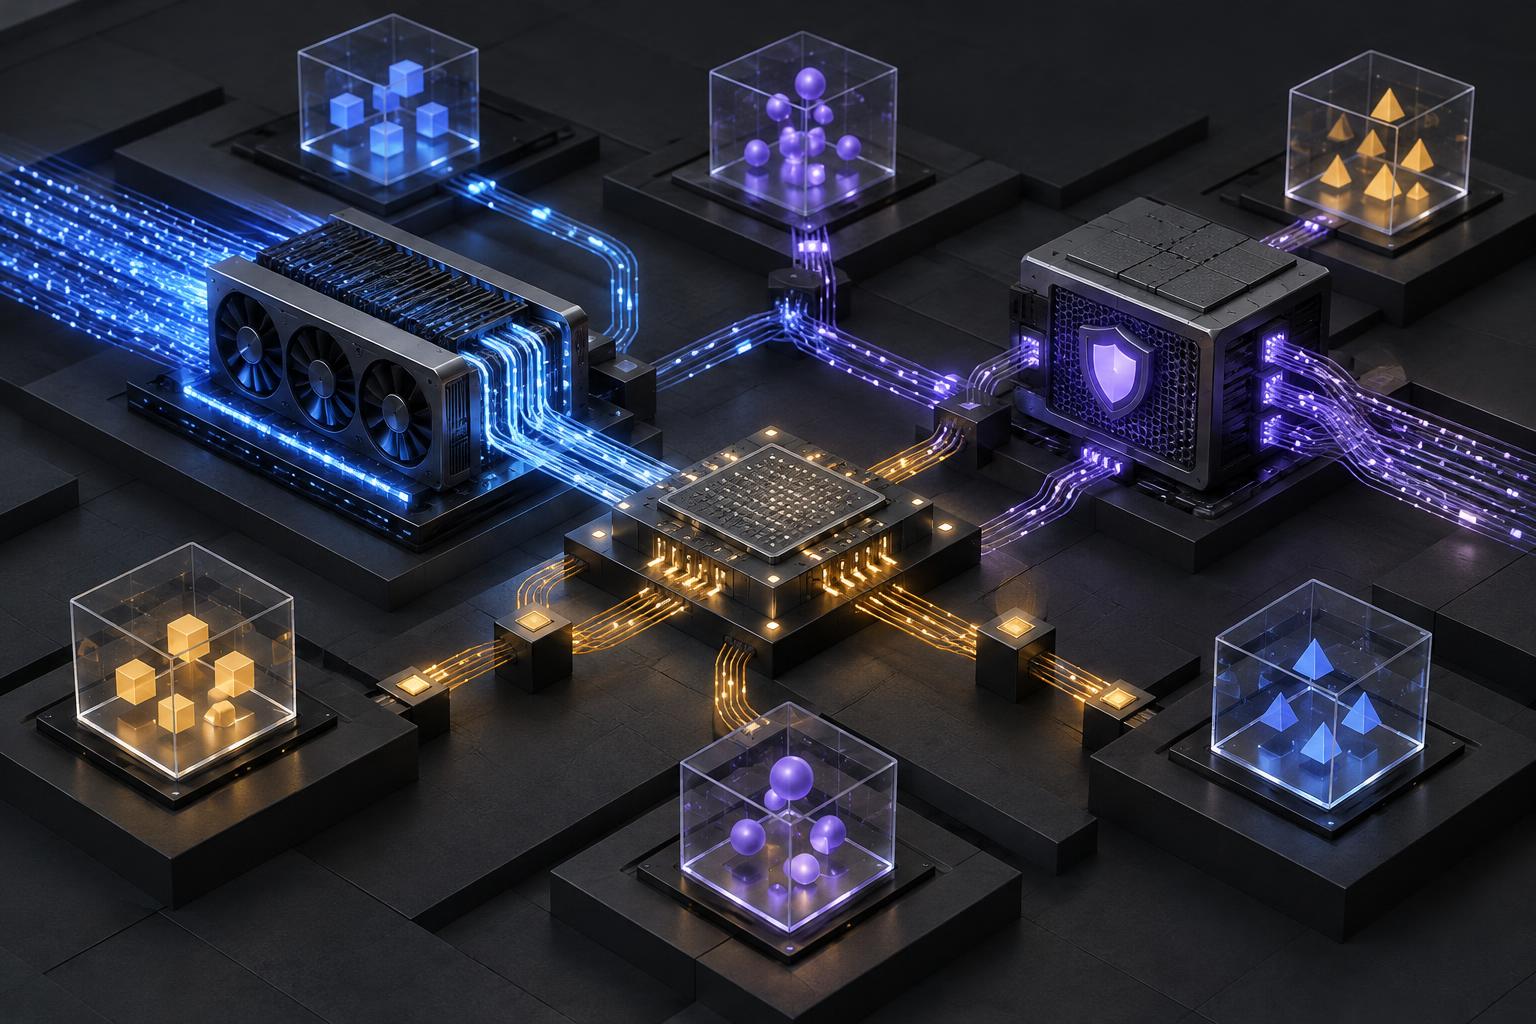
В октябре Nvidia представила Vera как часть более широкой архитектуры для агентных систем. В этой схеме GPU Vera Rubin отвечает за инференс, CPU Vera — за выполнение агентной логики и инструментов, а сетевой процессор BlueField-4 DPU — за мониторинг и применение политик безопасности.
Такой подход показывает, как меняется конкуренция на рынке. Производителям уже недостаточно предложить самый быстрый чип для одной операции. Им нужно показать, как процессоры, ускорители, сеть и средства изоляции работают вместе.
Однако это не означает, что Nvidia вытеснила Intel и AMD из серверов. Результат Modal — внутреннее тестирование конкретной нагрузки, а не независимый универсальный бенчмарк. Сравнение проводилось с установленными у компании конфигурациями, а новые поколения конкурирующих процессоров могут изменить соотношение. Корректнее говорить о растущем спросе на быстрые CPU для агентных задач, а не о завершённой победе одного поставщика.
Что измерять компаниям
1. Время завершения сценария
Показатель «токенов в секунду» полезен для оценки инференса, но недостаточен для агента. Важнее знать, сколько времени проходит от запроса до результата, какова доля успешных завершений и сколько стоит одна выполненная задача.
2. Задержку каждого шага
Нужно отдельно измерять инференс, запуск контейнера, работу файловой системы, сетевые вызовы, обращение к базе данных и повторные попытки. Такой профиль быстро показывает, где находится настоящее узкое место.
3. Поведение при росте нагрузки
Агент может работать быстро для одного пользователя и резко замедляться при сотнях параллельных запусков. Поэтому тестировать следует не только среднее время, но и задержки самых медленных операций, например на 95-м или 99-м процентиле.
4. Готовность программного стека
Переход на Arm-совместимый CPU требует проверить контейнерные образы, библиотеки, инструменты сборки и зависимости. Смешанный парк также усложняет мониторинг и поддержку: одинаковый сценарий может вести себя по-разному на разных архитектурах.
Вывод
AI-агент — это не языковая модель, подключённая к нескольким кнопкам. Это распределённая система, которая постоянно переключается между инференсом, кодом, сетью, хранилищем и изолированными средами.
Поэтому следующим инфраструктурным вопросом после выбора модели становится не только «какой GPU купить», а «на каком CPU агент выполнит всю работу между двумя вызовами модели». Для одних задач оптимальным окажется мощный процессор Nvidia, для других — современная платформа Intel или AMD. Выбор стоит делать после профилирования реального сценария, а не по одному показателю скорости генерации токенов.


