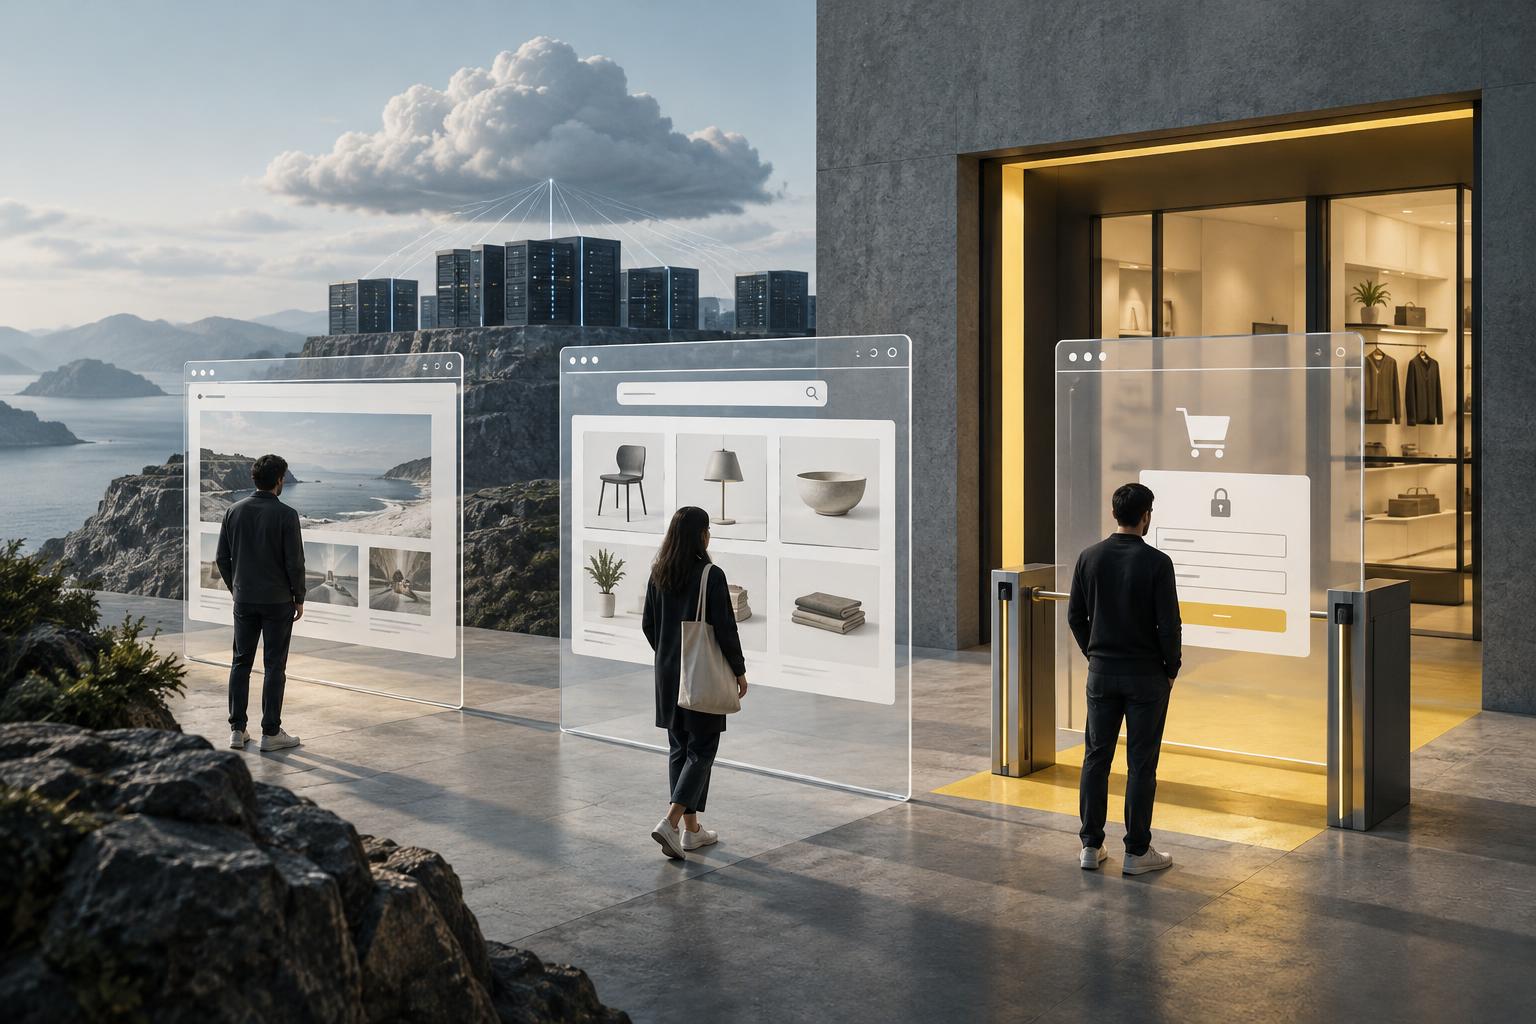
Новый посетитель на сайте
Интернет привык к простой схеме: человек приходит через браузер, поисковый робот сообщает о себе, а подозрительный скрипт выдаёт себя частотой запросов или странным user-agent. Для многих сайтов эта модель до сих пор лежит в основе защиты.
Но облачные AI-агенты меняют саму постановку задачи. Они могут открывать страницы, переходить по ссылкам, искать товары и заполнять формы через полноценный браузер. При этом агент работает не с домашнего компьютера пользователя, а из виртуальной машины в облаке. Для сайта такой визит выглядит как обычный браузерный трафик из дата-центра или CDN.
Вопрос теперь звучит не так: «Перед нами человек или бот?» Гораздо полезнее спросить: «Что именно посетитель собирается сделать — и можно ли ему это разрешить?»
Что показывает рост агентского трафика
В отчёте DataDome за третий квартал 2026 года говорится, что сеть компании зафиксировала почти 25 млрд запросов от AI-агентов. Это на 41,5% больше, чем во втором квартале, когда показатель составлял 17,7 млрд.
Отдельно вырос трафик так называемых агентских браузеров. В сентябре он увеличился примерно с 12,5 млн до 58,2 млн запросов — в 4,7 раза.
В исследовании приводится пример Meta Muse. По описанию Meta, агент работает внутри выделенной защищённой виртуальной машины с браузером. За первые 12 дней полноценной доступности — с 22 сентября по 3 октября 2026 года — он сгенерировал 29,1 млн запросов. В выборке DataDome 99,3% трафика Muse пришлось на облачную и CDN-инфраструктуру, а не на сети обычных интернет-провайдеров.
Эти цифры важно правильно интерпретировать. DataDome измеряла собственную сеть, а не весь интернет. Запросы — это не пользователи, покупки или успешно выполненные задачи. Однако архитектурный вывод от этого не меняется: браузерный агент уже может массово обращаться к сайтам, не обозначая себя так явно, как традиционный поисковый робот.
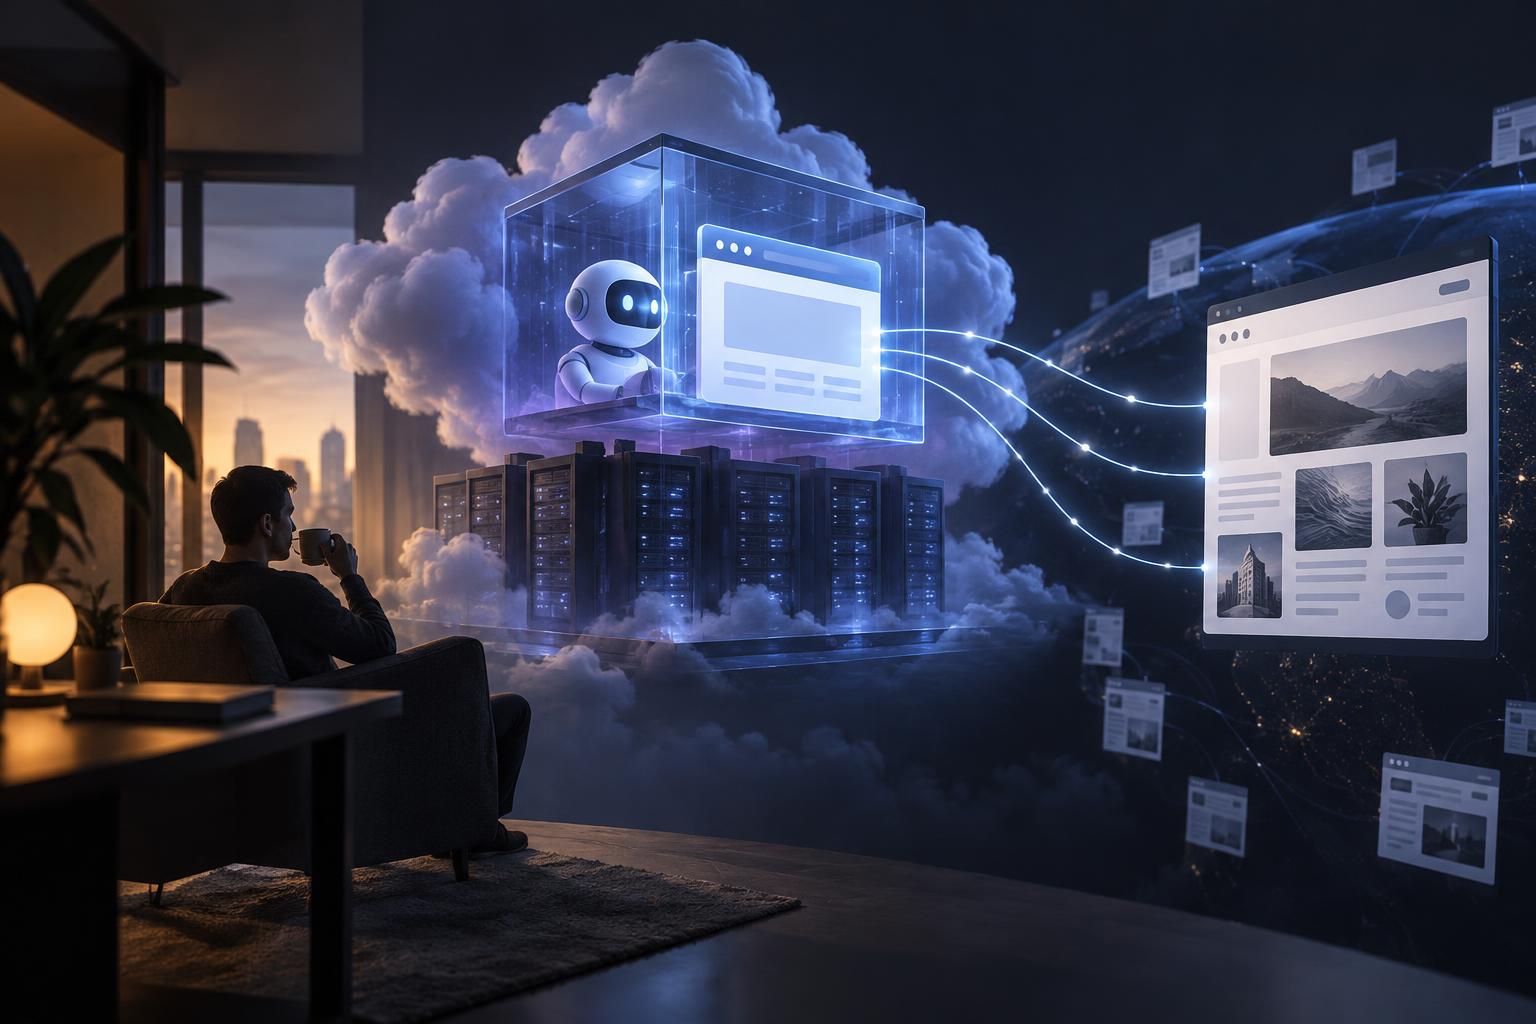
Иллюстрация: ИИ
Почему старые признаки перестают работать
IP-адрес не рассказывает о намерении
Облачные сервисы используют большие диапазоны адресов, а один и тот же поставщик инфраструктуры может обслуживать совершенно разные сценарии. За IP-адресом CDN может находиться легитимный агент, который сравнивает тарифы для клиента, или автоматизированный скрипт, собирающий цены и перегружающий поиск.
Заблокировать весь облачный диапазон проще всего, но такой подход может закрыть доступ полезным инструментам и части реальных пользователей.
User-agent легко становится неинформативным
Классические краулеры часто сообщают о себе специальным именем — например, через отдельную строку user-agent. Браузерный агент может использовать обычный браузерный стек и не попадать в список известных ботов.
Это не означает, что любой агент намеренно маскируется. Он может просто работать в среде, где браузер выглядит максимально стандартно. Для системы защиты результат один: по одной строке user-agent надёжный вывод сделать нельзя.
Robots.txt не управляет действиями пользователя
Файл robots.txt создавался прежде всего для рекомендаций поисковым роботам. Он может сообщить краулеру, какие страницы не стоит индексировать, но не является системой идентификации, авторизации или контроля транзакций.
Если агент открывает каталог, обращается к поиску, создаёт аккаунт или пытается оформить заказ, robots.txt не отвечает на главный вопрос: какие операции ему разрешены.
От блокировки — к уровням доверия
Для бизнеса полезнее разделить доступ не на «человеческий» и «машинный», а на уровни действий.
Открытое чтение
Публичные статьи, карточки товаров, условия доставки и страницы справки можно сделать доступными для широкого круга посетителей. Ограничения здесь могут касаться частоты запросов и нагрузки, но не обязательно самого факта автоматизации.
Поиск и сравнение
Поиск по каталогу, фильтрация и сравнение товаров требуют более строгого контроля. Сайт может ограничивать скорость обращений, число последовательных запросов и подозрительные комбинации параметров, не блокируя весь облачный трафик.
Создание аккаунта и работа с профилем
Регистрация, изменение контактных данных и доступ к истории заказов уже связаны с личной информацией. Здесь нужны подтверждение пользователя, привязка к сессии и более подробное журналирование действий.
Заказ и оплата
Платёж — операция с максимальной ценой ошибки. Даже если агент самостоятельно собирает корзину, финальное подтверждение может оставаться за человеком: через приложение, одноразовый код или явное действие в доверенном интерфейсе.
Такой подход позволяет не запрещать агентам читать и искать, но не даёт им автоматически менять настройки, создавать множество аккаунтов или проводить платежи.
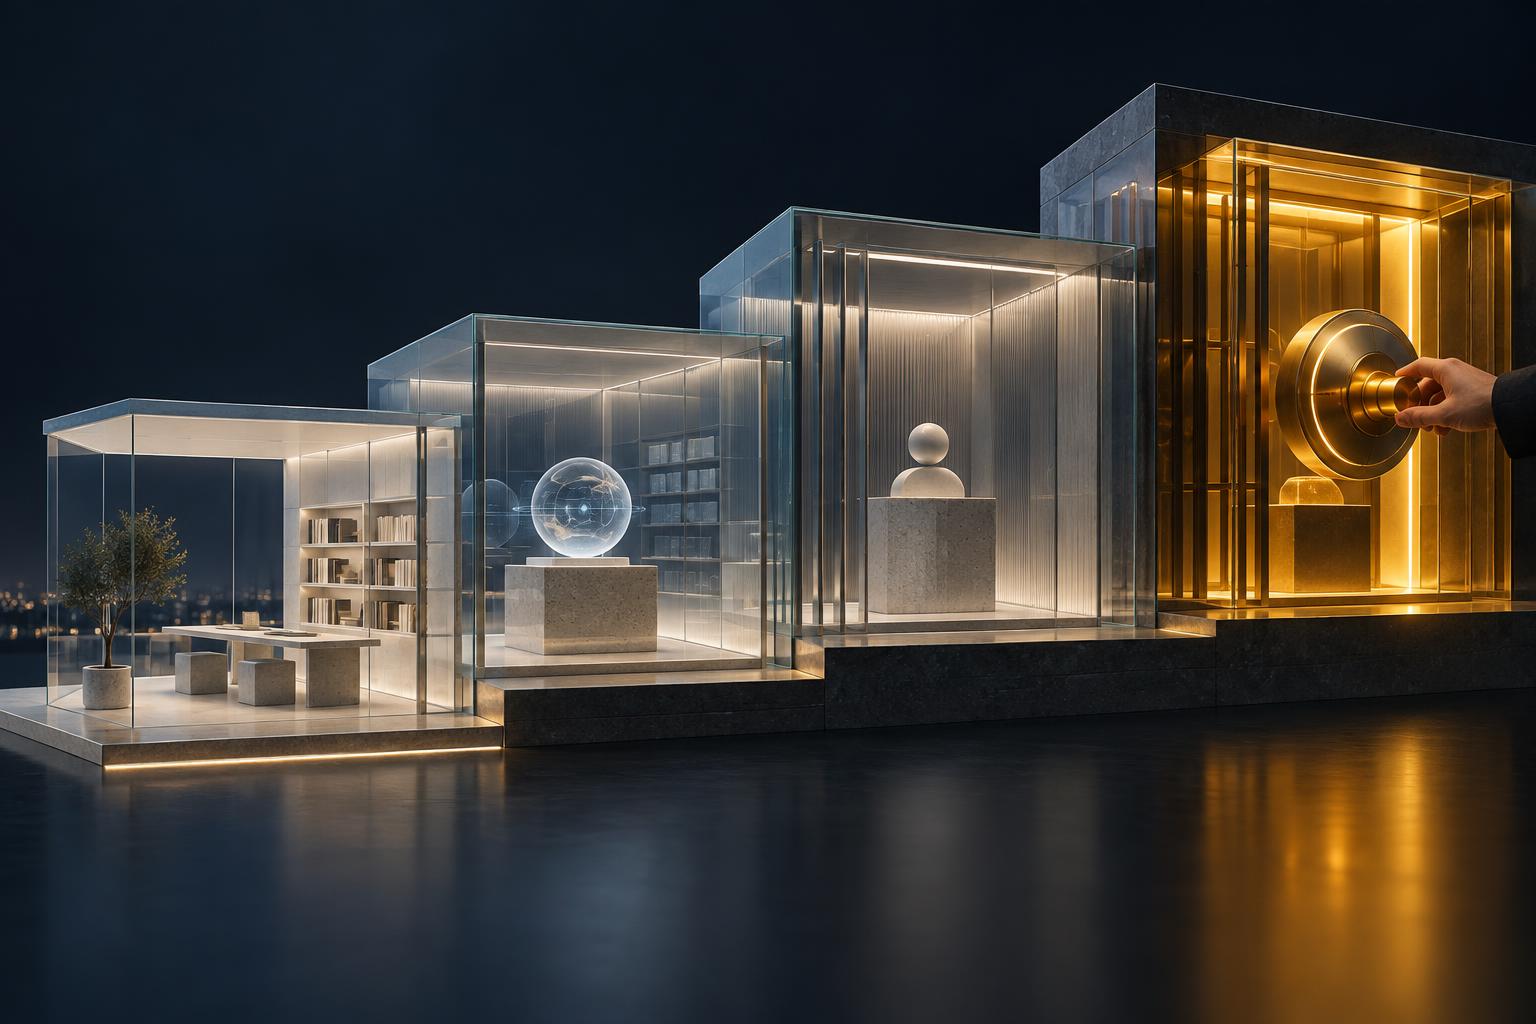
Иллюстрация: ИИ
Что стоит внедрить уже сейчас
Первый шаг — провести аудит облачного трафика. Важно смотреть не только на IP и user-agent, но и на последовательность действий: сколько страниц открывается за сессию, как быстро меняются параметры поиска, сколько запросов заканчивается ошибкой, повторяются ли одни и те же операции.
Второй шаг — выделить чувствительные маршруты: регистрацию, авторизацию, восстановление доступа, корзину, промокоды, API и оплату. Для каждого из них стоит определить допустимый уровень автоматизации и условия дополнительного подтверждения.
Третий шаг — вести журнал действий, а не только событий входа. Запись «запрос пришёл из облака» мало что объясняет. Гораздо полезнее видеть, какие страницы открывались, какие формы отправлялись, какие изменения были внесены и на каком этапе потребовалось подтверждение.
Наконец, правила должны учитывать контекст. Один IP-адрес или необычный браузер не доказывают злоупотребление. Более весомыми признаками становятся массовость, повторяемость, несоответствие заявленному сценарию, высокий процент ошибок и попытки обойти ограничения.
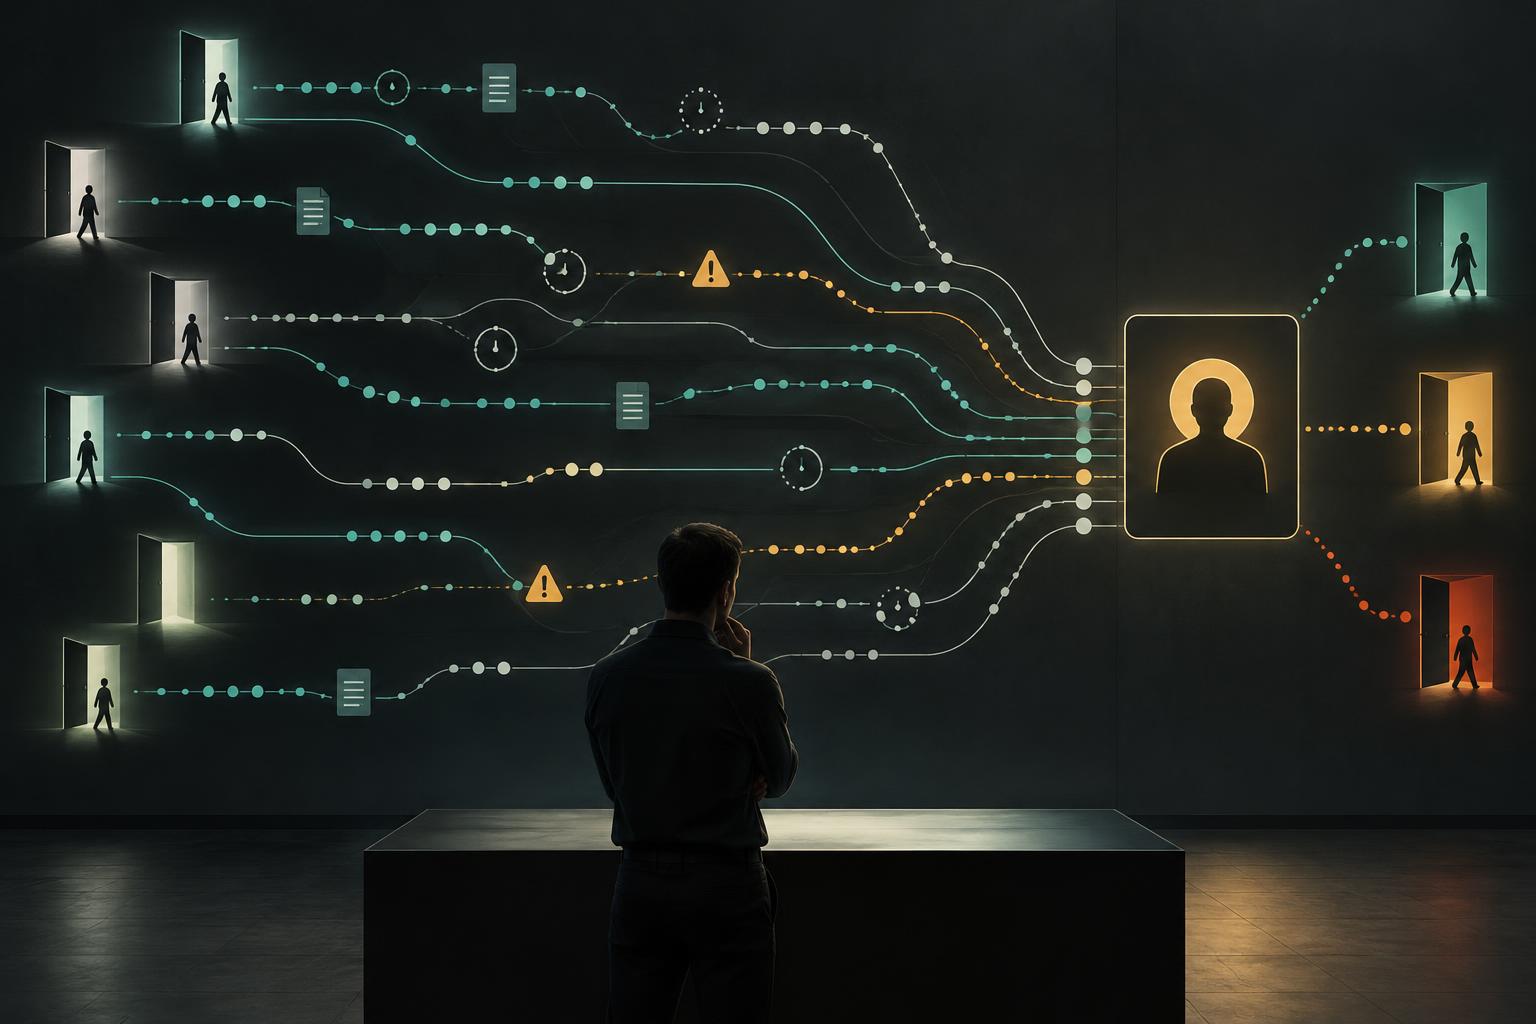
Иллюстрация: ИИ
Сайт теперь должен понимать не только «кто», но и «что»
Облачные AI-агенты не отменяют защиту от автоматизации, но делают устаревшей её бинарную версию. Полностью закрывать дата-центры — значит рисковать легитимными сценариями. Бесконтрольно пропускать браузерный трафик — значит отдавать автоматизированным системам слишком много возможностей.
Рабочая модель выглядит иначе: разрешать чтение, ограничивать интенсивность поиска, отдельно защищать аккаунты и требовать подтверждение для финансовых и необратимых операций. В такой архитектуре сайт не пытается угадать, является ли посетитель человеком. Он проверяет, достаточно ли доверия для конкретного действия.


