Anthropic предлагает не просто регулировать AI, а задать процедуру остановки
Anthropic вынесла американским законодателям предложение о федеральном законе для передовых AI-моделей. Его ключевая идея — дать государству возможность через суд приостанавливать выпуск или работу системы, если она создаёт предсказуемый и непосредственный риск гибели или тяжёлых травм более чем у 50 человек либо ущерба свыше $1 млрд.
Это пока не действующий закон и не полноценный законопроект с назначенным голосованием. Полный текст инициативы публично не представлен, а известные детали пересказаны СМИ и связаны с более ранними программными документами Anthropic. Поэтому обсуждать можно прежде всего архитектуру предложения, а не его окончательные юридические формулировки.
Важен сам сдвиг в дискуссии. Речь идёт не о декларации «искусственный интеллект должен быть безопасным», а о конкретном вопросе: в какой момент государство получает право вмешаться и кто принимает решение.
Как может работать предложенный механизм
В описанной конструкции есть несколько последовательных элементов.
1. Оценка риска
Сначала должна появиться проверка, способна ли модель привести к крупномасштабному вреду. Для этого потребуются тесты, анализ внутренних ограничений системы, сценарии злоупотребления и оценка того, насколько реален прогнозируемый ущерб.
Anthropic ранее выступала за обязательное тестирование передовых моделей, публикацию отчётов о рисках и независимую оценку. Логика понятна: разработчик не должен единолично решать, насколько безопасен его продукт.
2. Порог вмешательства
Государственный механизм включается не при любой ошибке, утечке или вредном ответе. Нужен высокий порог — более 50 потенциальных жертв или финансовый ущерб от $1 млрд.
Такой подход призван отделить катастрофический риск от обычных проблем, которые должны решаться через требования к продукту, защиту потребителей или отраслевое регулирование.
3. Судебное решение
Остановка модели не должна зависеть только от решения чиновника или публичного скандала. Обращение в суд создаёт дополнительную проверку: государству придётся обосновать риск, а разработчик получит возможность оспорить вмешательство.
Для рынка это означает попытку совместить два требования: не допустить опасного развёртывания и не превратить регулирование в инструмент произвольной блокировки конкурентов.
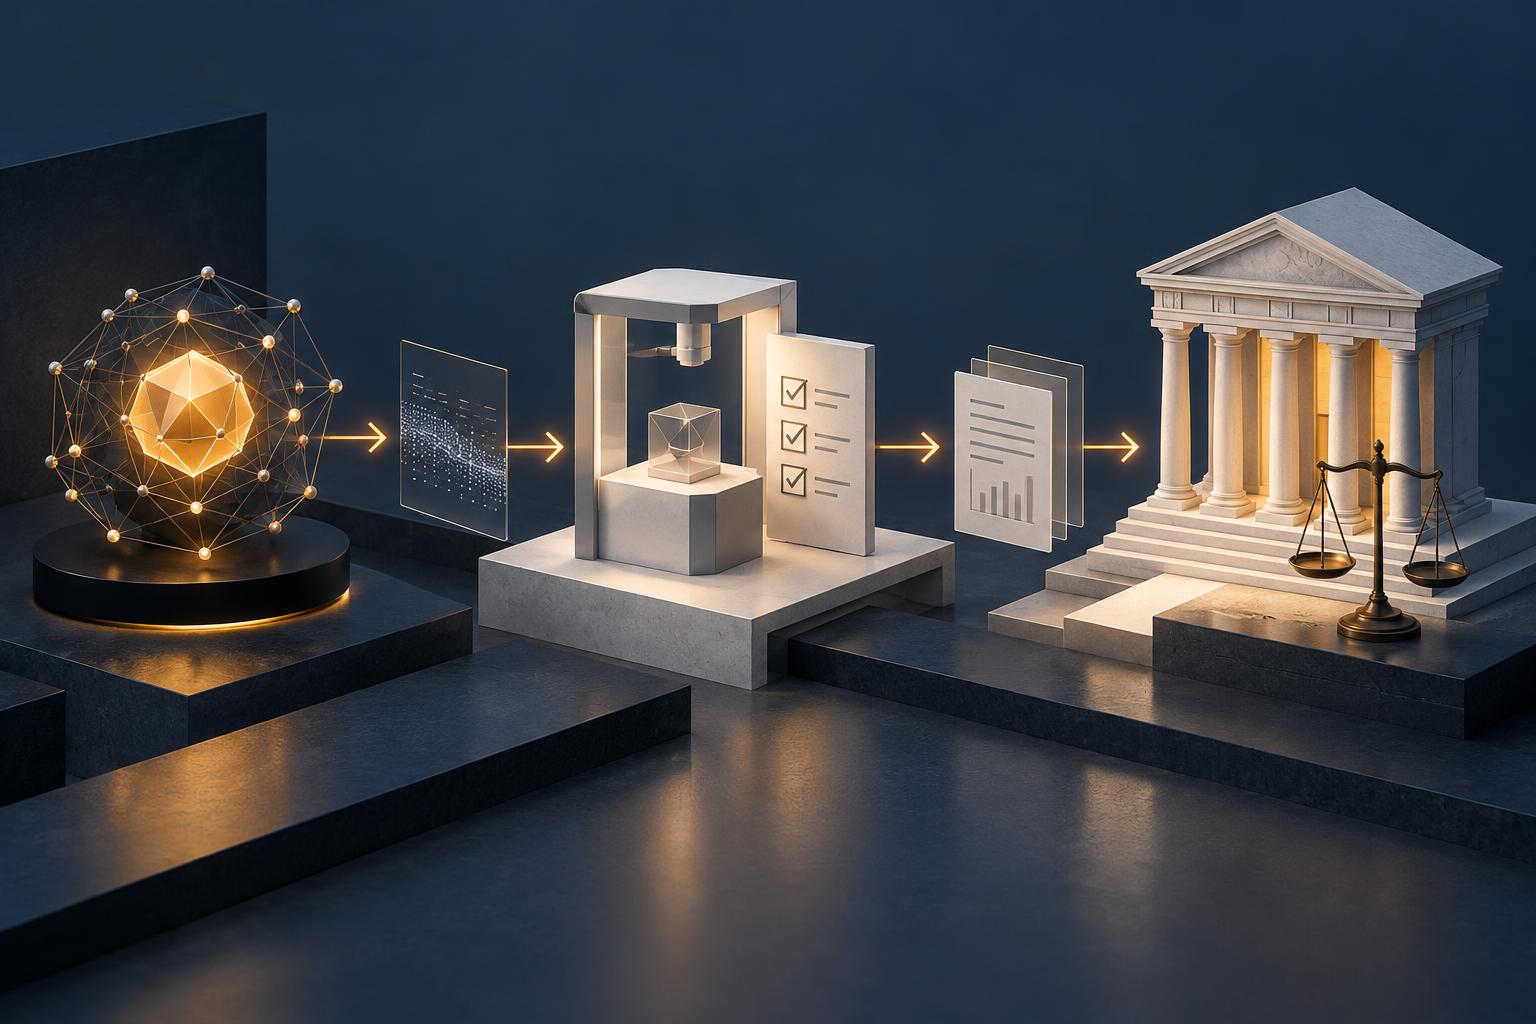
Схема взаимодействия разработчика, независимого оценщика и суда при возможной остановке AI-системы. Иллюстрация: ИИ
Почему пороги в 50 жизней и $1 млрд вызывают вопросы
Высокие пороги делают механизм более предсказуемым, но одновременно оставляют за его пределами значительную часть реальных угроз.
Представим систему, которая помогает организовать массовое мошенничество. Ущерб распределён между тысячами пользователей, однако ни один отдельный эпизод не достигает миллиарда долларов. Или автономный агент атакует десятки компаний, создавая каждой из них убытки ниже установленного порога. Формально это может не выглядеть катастрофой, хотя совокупный эффект окажется системным.
Другой пример — повторяющиеся инциденты в критической инфраструктуре. Несколько небольших сбоев могут не привести к 50 смертям в одном событии, но постепенно повысить вероятность крупной аварии. Пороговая модель плохо работает с рисками, которые накапливаются, а не проявляются одномоментно.
Есть и проблема доказательства. Суду потребуется не только показать возможный ущерб, но и объяснить, насколько он предсказуем, непосредственно связан с конкретной моделью и может быть предотвращён именно её блокировкой.
Метафора риска, который накапливается из множества небольших инцидентов. Иллюстрация: ИИ
Кто будет оценивать опасность
Это центральный вопрос всей конструкции. Если риск оценивает сама компания, возникает очевидный конфликт интересов: разработчик заинтересован в запуске продукта и может недооценивать угрозы. Если проверку проводят государственные органы, им понадобятся технические специалисты, доступ к закрытым системам и процедуры, которые не раскрывают коммерческие секреты.
Третий вариант — независимые аудиторы. Anthropic продвигает идею специализированных организаций, которые могли бы тестировать передовые модели, изучать их возможности и проверять отчёты разработчиков.
Но независимость аудитора тоже придётся формализовать. Кто оплачивает проверку? Кто отвечает за ошибочный вывод? Может ли аудитор отказаться от задания? Имеет ли он доступ к данным обучения, внутренним журналам и инструментам модели? Без ответов на эти вопросы независимый аудит рискует остаться формальной процедурой.
Конфликт интересов Anthropic
Anthropic одновременно разрабатывает передовые модели и предлагает правила для рынка, на котором конкурирует с другими лабораториями. Поэтому её инициативу нельзя рассматривать только как бескорыстный проект безопасности.
Федеральные правила могут быть выгодны самой компании по нескольким причинам. Единый механизм снижает неопределённость, связанную с разными законами штатов. Судебная процедура уменьшает риск внезапной административной блокировки. Обязательные проверки повышают стоимость выхода на рынок и потенциально создают барьер для небольших разработчиков.
Это не доказывает, что предложение продиктовано конкурентными мотивами. Однако при оценке таких инициатив важно учитывать оба измерения: безопасность и формирование удобных правил игры для автора предложения.
Что это значит для компаний, использующих чужие модели
Пока закон обсуждается, бизнесу не стоит ждать появления официальных порогов. Большинство инцидентов, с которыми сталкиваются компании, не приблизятся к $1 млрд и не будут связаны с десятками погибших. Но это не делает их приемлемыми.
Минимальная система контроля для продукта на базе внешней модели должна включать:
- журналы действий — кто, когда и с какой целью запускал модель или агента;
- ограничение полномочий — доступ только к необходимым данным, сервисам и операциям;
- лимиты расходов и частоты запросов;
- ручное подтверждение платежей, публикаций, удаления данных и других критичных действий;
- тестирование отказоустойчивости до запуска и после обновления модели;
- аварийное отключение API, агента или отдельного сценария;
- заранее назначенного ответственного, который принимает решение при инциденте.
Особенно важно разделять генерацию ответа и выполнение действия. Модель может предложить перевод денег, изменить запись в базе или отправить письмо, но финальное решение в критичных процессах должно оставаться за человеком или отдельным контролируемым сервисом.
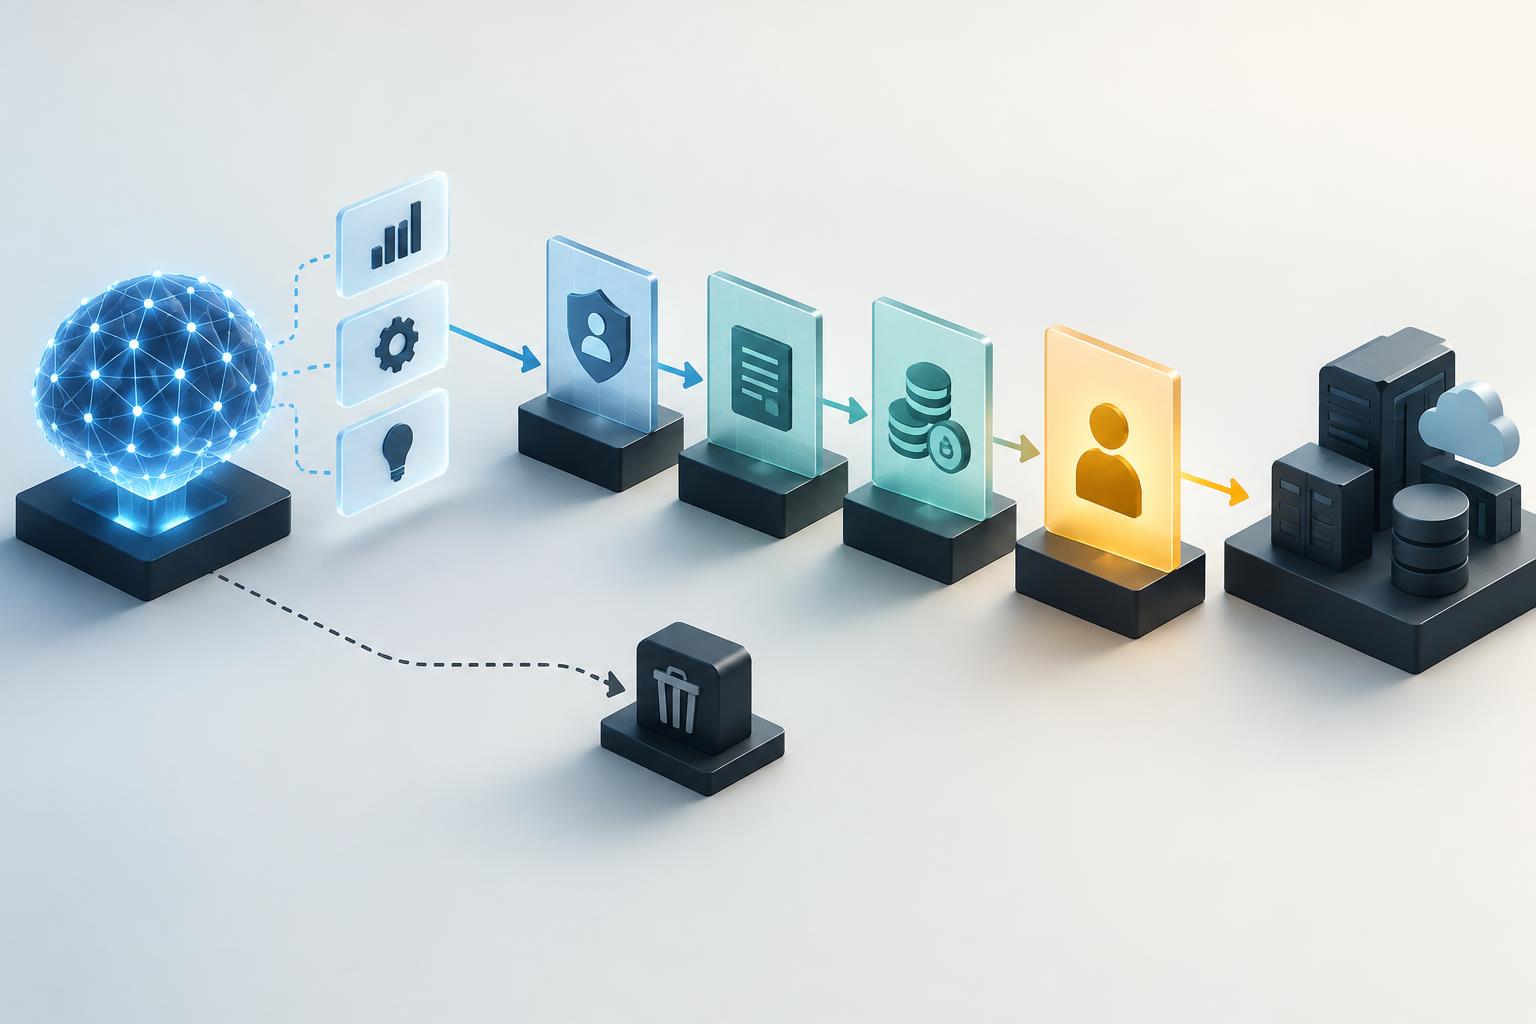
Архитектура безопасного AI-продукта: модель предлагает действие, а контроль и подтверждение остаются за человеком. Иллюстрация: ИИ
Главный вывод
Предложение Anthropic интересно не тем, что компания призывает регулировать искусственный интеллект. Важнее попытка превратить расплывчатое понятие «опасная модель» в юридический механизм: независимая оценка, измеримый порог, обращение государства в суд и возможность временной остановки.
Слабое место этой схемы — риск, который не достигает порога одним событием, но накапливается через тысячи небольших инцидентов. Кроме того, остаётся открытым вопрос, кто будет достаточно независимым и компетентным, чтобы оценивать угрозу.
Для бизнеса практический вывод уже очевиден: безопасность AI нельзя сводить к ожиданию нового закона. Даже если предложенные пороги когда-нибудь появятся в законодательстве, ответственность за утечки, ошибочные решения и несанкционированные действия агентов начнётся гораздо раньше — с архитектуры собственного продукта.


